



LLaMA là dòng mô hình ngôn ngữ lớn do Meta phát triển, có khả năng tạo văn bản, trả lời câu hỏi và hỗ trợ lập trình. Khác với ChatGPT được cung cấp như một trợ lý AI, LLaMA cho phép nhà phát triển chủ động triển khai và tùy chỉnh mô hình theo nhu cầu. Vậy LLaMA hoạt động như thế nào và có những điểm khác biệt gì so với ChatGPT?
LLaMA là gì?
LLaMA (Large Language Model Meta AI) là dòng mô hình ngôn ngữ lớn được Meta phát triển, ứng dụng trí tuệ nhân tạo để hiểu và tạo nội dung bằng ngôn ngữ tự nhiên. Meta cung cấp các mô hình Llama để nhà phát triển có thể tải xuống, tùy chỉnh và triển khai theo điều kiện giấy phép tương ứng.
Khác với các chatbot AI chỉ cung cấp trải nghiệm tương tác trực tiếp, LLaMA cho phép nhà phát triển tải mô hình, tinh chỉnh và triển khai vào các ứng dụng riêng theo điều kiện giấy phép của Meta. Nhờ đó, công nghệ này được ứng dụng trong phát triển trợ lý ảo, chatbot doanh nghiệp và các giải pháp AI tùy chỉnh.
Cách thức hoạt động của LLaMA
LLaMA hoạt động dựa trên kiến trúc Transformer, sử dụng cơ chế học sâu để phân tích mối quan hệ giữa các token trong dữ liệu và dự đoán nội dung tiếp theo. Quá trình này gồm hai giai đoạn chính: huấn luyện mô hình trên tập dữ liệu lớn và tạo phản hồi khi nhận yêu cầu từ người dùng.
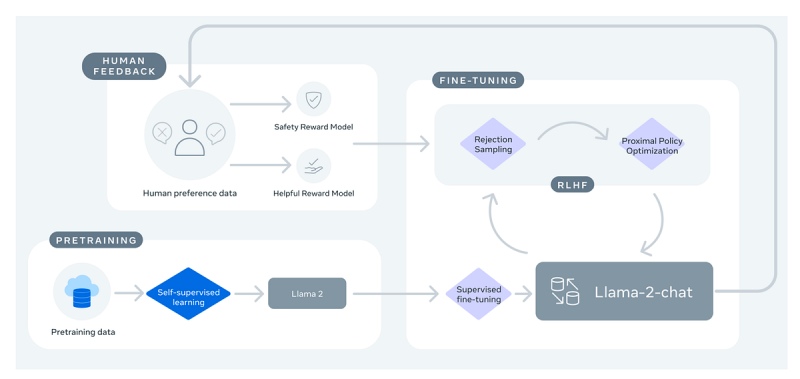
Ngoài huấn luyện ban đầu, một số phiên bản LLaMA còn được tinh chỉnh bằng dữ liệu hướng dẫn và phản hồi của con người để cải thiện khả năng làm theo yêu cầu, độ hữu ích và tính an toàn. Với những phiên bản hỗ trợ đa phương thức như Llama 4, mô hình còn có thể xử lý thông tin hình ảnh cùng văn bản.
>>> Xem thêm: Chatbot AI Nhân Hòa AIO - Tối ưu chăm sóc khách hàng, tăng chuyển đổi
4 Phiên bản của LLaMA
Meta đã phát triển bốn thế hệ chính của Llama, từ Llama 1 đến Llama 4, với những cải tiến liên tục về kiến trúc, hiệu suất và khả năng xử lý dữ liệu.
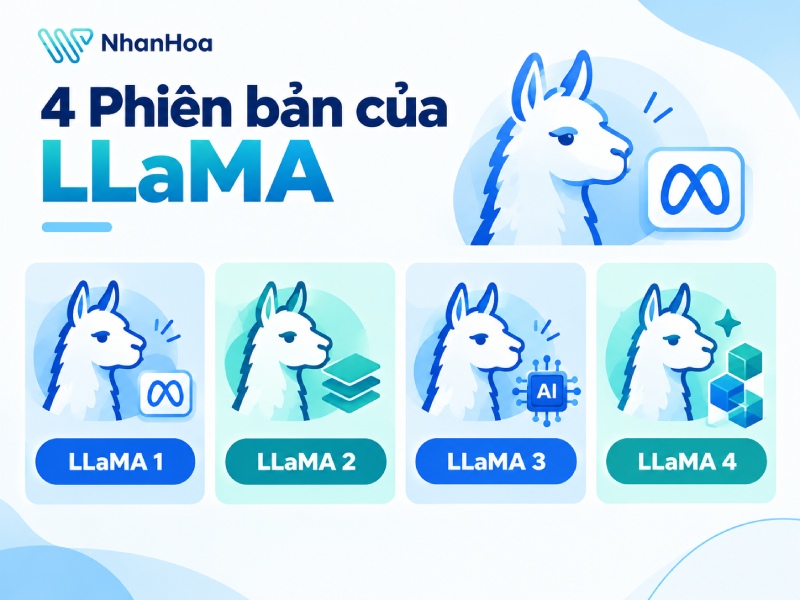
LLaMA 1 (2023)
Ra mắt vào tháng 2/2023, LLaMA 1 gồm các mô hình có quy mô từ 7 tỷ đến 65 tỷ tham số, ban đầu được phát hành chủ yếu phục vụ nghiên cứu theo giấy phép phi thương mại. Thế hệ này cho thấy các mô hình ngôn ngữ có thể đạt hiệu quả đáng kể mà không nhất thiết phải sử dụng kiến trúc có quy mô cực lớn. Đồng thời, LLaMA 1 tạo nền tảng cho cộng đồng phát triển nhiều mô hình tinh chỉnh và ứng dụng AI mới.
LlaMA 2 (2023)
Ra mắt vào tháng 7/2023, Llama 2 cung cấp các phiên bản 7B, 13B và 70B tham số, được huấn luyện trên lượng dữ liệu nhiều hơn khoảng 40% so với thế hệ trước. Meta cũng mở rộng điều kiện sử dụng cho mục đích thương mại theo giấy phép riêng.
Bên cạnh mô hình hội thoại Llama 2 Chat, hệ sinh thái này còn có Code Llama, dòng mô hình chuyên biệt cho lập trình, hỗ trợ tạo mã, giải thích và hoàn thiện mã nguồn.
LlaMA 3 (2024)
Llama 3 đánh dấu bước tiến về khả năng hiểu ngôn ngữ, suy luận và tạo nội dung. Các phiên bản tiếp theo như Llama 3.1, Llama 3.2 và Llama 3.3 tiếp tục mở rộng năng lực của dòng mô hình, trong đó Llama 3.1 hỗ trợ cửa sổ ngữ cảnh lên tới 128.000 token và được huấn luyện trên hơn 15 nghìn tỷ token. Đến Llama 3.2, Meta bổ sung các mô hình hỗ trợ xử lý hình ảnh, mở rộng ứng dụng sang những tác vụ kết hợp văn bản và dữ liệu trực quan.
LlaMA 4 (2025)
Llama 4 được Meta giới thiệu vào tháng 4/2025, nổi bật với kiến trúc Mixture of Experts (MoE). Thay vì kích hoạt toàn bộ tham số trong mỗi lượt xử lý, kiến trúc này lựa chọn các nhóm chuyên gia phù hợp với đầu vào, qua đó cải thiện hiệu quả tính toán.
Hai phiên bản tiêu biểu là Llama 4 Scout và Llama 4 Maverick. Scout có tổng cộng khoảng 109 tỷ tham số, trong đó 17 tỷ tham số hoạt động cho mỗi token; Maverick có khoảng 400 tỷ tham số tổng cộng, với 17 tỷ tham số hoạt động cho mỗi token. Cả hai hỗ trợ xử lý văn bản và hình ảnh, đồng thời hướng đến những ứng dụng cần xử lý ngữ cảnh dài.
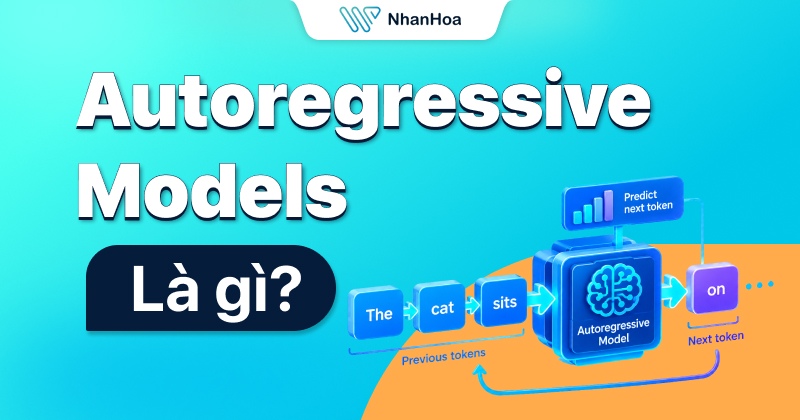
>>> Xem thêm: Autoregressive Models là gì? Công nghệ cốt lõi của AI tạo sinh
Ưu điểm và nhược điểm của LLaMA
Bên cạnh tiềm năng ứng dụng rộng rãi, LLaMA vẫn tồn tại một số thách thức về tài nguyên tính toán, độ chính xác và yêu cầu kỹ thuật.
Khác biệt giữa LLaMA với ChatGPT
Dù cùng ứng dụng mô hình ngôn ngữ lớn, LLaMA và ChatGPT có cách tiếp cận khác nhau. Cùng tìm hiểu qua bảng so sánh sau.
Ứng dụng của mô hình AI LLaMA
Mô hình AI LLaMA được ứng dụng trong nhiều lĩnh vực nhờ khả năng xử lý ngôn ngữ, tạo nội dung, lập trình và phân tích hình ảnh ở những phiên bản hỗ trợ đa phương thức.
- Tạo và xử lý nội dung: Viết bài, tóm tắt tài liệu, dịch thuật, phân loại văn bản và biên tập nội dung theo yêu cầu.
- Phát triển chatbot và trợ lý ảo: Xây dựng hệ thống hỏi đáp tự động, hỗ trợ khách hàng và tra cứu thông tin nội bộ.
- Hỗ trợ lập trình: Sinh mã nguồn, giải thích code, phát hiện lỗi và đề xuất cách sửa chữa.
- Phân tích hình ảnh và tài liệu: Nhận diện nội dung hình ảnh, trích xuất văn bản, đọc biểu đồ và trả lời câu hỏi về dữ liệu trực quan trên các phiên bản hỗ trợ thị giác.
- Giáo dục và nghiên cứu: Giải thích kiến thức, tổng hợp tài liệu, hỗ trợ học tập và phân tích thông tin.
- Phân tích dữ liệu doanh nghiệp: Phân loại phản hồi khách hàng, tổng hợp báo cáo và trích xuất thông tin từ dữ liệu nội bộ.
- Phát triển ứng dụng AI tùy chỉnh: Tích hợp mô hình vào phần mềm, tinh chỉnh theo nhu cầu và triển khai trên hạ tầng phù hợp
Tiềm năng của LLaMA trong tương lai
LLaMA có tiềm năng phát triển mạnh trong tương lai nhờ khả năng tùy chỉnh linh hoạt và ứng dụng đa dạng. Các phiên bản mới có thể tiếp tục cải thiện năng lực suy luận, xử lý đa phương thức và tối ưu hiệu suất, mở rộng khả năng triển khai trên nhiều nền tảng và thiết bị.
Bên cạnh đó, LLaMA có thể thúc đẩy việc phát triển chatbot, trợ lý AI cá nhân hóa và các hệ thống tự động hóa trong doanh nghiệp. Tuy nhiên, để khai thác hiệu quả tiềm năng này, cần tiếp tục giải quyết những thách thức về độ chính xác, bảo mật dữ liệu, tài nguyên tính toán và điều kiện cấp phép sử dụng.
[FAQs] Các câu hỏi thường gặp về LLAMA
LLaMA có miễn phí không?
Meta cho phép tải xuống và sử dụng LLaMA theo điều khoản cấp phép riêng. Người dùng cần kiểm tra quy định của từng phiên bản, đặc biệt khi sử dụng thương mại.
LLaMA sử dụng kiến trúc mô hình nào?
LLaMA chủ yếu sử dụng kiến trúc Transformer tự hồi quy để dự đoán token tiếp theo. Llama 4 áp dụng kiến trúc Mixture of Experts (MoE), chỉ kích hoạt một phần tham số cho mỗi token nhằm tăng hiệu quả tính toán.
Fine-tuning LLaMA là gì và khi nào nên thực hiện?
Fine-tuning là quá trình huấn luyện bổ sung bằng dữ liệu chuyên biệt để điều chỉnh mô hình theo từng nhiệm vụ. Phương pháp này phù hợp khi cần cải thiện phong cách phản hồi, kiến thức chuyên ngành hoặc định dạng đầu ra.
LLaMA có thể tích hợp dữ liệu nội bộ của doanh nghiệp không?
Có. Doanh nghiệp có thể kết hợp LLaMA với RAG để truy xuất tài liệu nội bộ khi trả lời câu hỏi mà không cần huấn luyện lại mô hình. Cần thiết lập quyền truy cập và bảo vệ dữ liệu phù hợp.
Làm thế nào để tối ưu hiệu suất khi triển khai LLaMA?
Có thể chọn mô hình phù hợp, áp dụng lượng tử hóa để giảm bộ nhớ và sử dụng phần cứng tương thích. Hiệu suất cần được đánh giá qua độ chính xác, tốc độ phản hồi và chi phí vận hành.
Lời kết
Với khả năng tạo nội dung, hỗ trợ lập trình và phát triển ứng dụng AI riêng, LLaMA mang đến nhiều lựa chọn cho cá nhân và doanh nghiệp. Tùy vào yêu cầu tùy chỉnh, nguồn lực kỹ thuật và mục tiêu triển khai, bạn có thể cân nhắc LLaMA hoặc ChatGPT để khai thác hiệu quả sức mạnh của trí tuệ nhân tạo.
 Tầng 4, Tòa 97–99 Láng Hạ, Phường Đống Đa, Thành phố Hà Nội
 Điện thoại:
 Mail: sales@nhanhoa.com
 Phản ánh chất lượng dịch vụ: