



Embeddings là gì? Tại sao công nghệ này đóng vai trò quan trọng trong các ứng dụng trí tuệ nhân tạo hiện nay? Từ tìm kiếm ngữ nghĩa đến hệ thống hỏi đáp bằng AI, embeddings biểu diễn dữ liệu dưới dạng vector để xác định mức độ tương đồng giữa các thông tin. Cùng Nhân Hòa tìm hiểu chi tiết về Embeddings qua bài viết dưới đây.
I. Embeddings là gì? Ví dụ về mô hình Embeddings
Embeddings (trong tiếng Việt là nhúng) là phương pháp biểu diễn dữ liệu (như văn bản, hình ảnh và âm thanh) dưới dạng các vector số trong không gian nhiều chiều, giúp mô hình AI và Machine Learning nhận diện đặc điểm và mức độ tương đồng về ngữ nghĩa giữa các dữ liệu.
Ví dụ: Hai cụm từ “mua laptop giá rẻ” và “tìm máy tính xách tay giá tốt” có cách viết khác nhau nhưng cùng thể hiện nhu cầu tìm mua laptop với chi phí thấp. Khi được xử lý bởi mô hình embedding phù hợp, hai cụm từ này có thể tạo ra các vector có độ tương đồng cao, giúp hệ thống tìm kiếm trả về kết quả sát với nhu cầu của người dùng.
II. Embeddings hoạt động như thế nào?
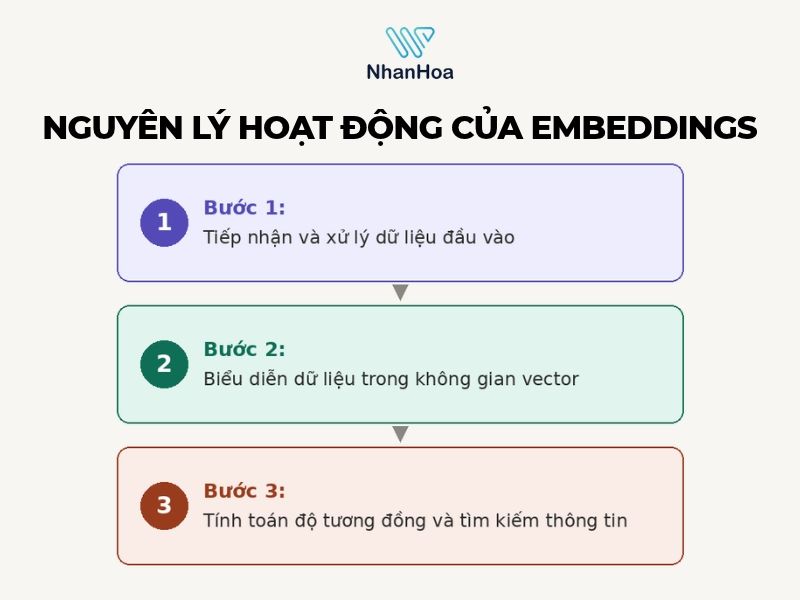
Embeddings hoạt động bằng cách chuyển đổi dữ liệu đầu vào thành các vector số thông qua một mô hình nhúng (Embedding Model). Tùy thuộc vào loại dữ liệu và mục đích sử dụng, nguyên lý hoạt động của Embeddings cơ bản như sau:
Bước 1: Tiếp nhận và xử lý dữ liệu đầu vào
Hệ thống chuyển dữ liệu như văn bản, hình ảnh hoặc âm thanh thành vector với tọa độ gồm trăm đến hàng nghìn con số. Kết quả tạo ra phụ thuộc vào mô hình embedding, dữ liệu đầu vào và cách mô hình được huấn luyện. Mỗi mô hình cũng có thể tạo vector với số chiều khác nhau, chẳng hạn 384, 768 hoặc 1.536 chiều.
Bước 2: Biểu diễn dữ liệu trong không gian vector
Các vector embedding có thể được hình dung như những điểm nằm trong một không gian nhiều chiều (Vector Space). Những dữ liệu có đặc điểm hoặc ngữ nghĩa tương đồng thường có xu hướng nằm gần nhau theo thước đo tương đồng mà hệ thống sử dụng.
Bước 3: Tính toán độ tương đồng và tìm kiếm thông tin
Khi đã có vector embedding, hệ thống có thể so sánh chúng bằng các phương pháp như Cosine Similarity, tích vô hướng (Dot Product) hoặc khoảng cách Euclidean (Euclidean Distance). Tùy theo phương pháp, hệ thống xác định những vector có mức độ tương đồng hoặc khoảng cách phù hợp để phục vụ mục đích tìm kiếm.
III. Các loại Embeddings phổ biến hiện nay
Embeddings được chia thành nhiều loại dựa trên dữ liệu đầu vào, đơn vị thông tin được biểu diễn và mục đích sử dụng. Các loại embeddings trong Machine Learning và AI hiện nay gồm có:
IV. Ứng dụng thực tế trong AI của Embeddings
Embeddings đóng vai trò quan trọng trong nhiều ứng dụng trí tuệ nhân tạo nhờ khả năng chuyển đổi dữ liệu thành vector số, giúp hệ thống nhận diện mối quan hệ và mức độ tương đồng giữa các thông tin.
- Semantic Search (Tìm kiếm ngữ nghĩa): Giúp hệ thống tìm kiếm hiểu ý nghĩa và ngữ cảnh của truy vấn. Nhờ đó, người dùng vẫn có thể tìm thấy thông tin liên quan ngay cả khi cách diễn đạt khác với nội dung tài liệu.
- Tăng cường khả năng trả lời của AI bằng dữ liệu bên ngoài (RAG): Chia tài liệu thành đoạn nhỏ, tạo embeddings cho từng đoạn, lưu vào vector database, tìm đoạn liên quan đến câu hỏi, rồi đưa các đoạn đó vào ngữ cảnh của LLM.
- Hỗ trợ Chatbot AI: Giúp trợ lý ảo xác định ý định và tìm kiếm nội dung liên quan đến câu hỏi của người dùng, kể cả khi câu hỏi được diễn đạt theo nhiều cách khác nhau.
- Gợi ý sản phẩm và nội dung: Hệ thống biểu diễn sản phẩm, bài viết hoặc video dưới dạng vector để xác định những mục có đặc điểm và chủ đề tương đồng. Từ đó, nền tảng đề xuất sản phẩm hoặc nội dung phù hợp với người tìm kiếm.
- Phân loại dữ liệu: Xử lý nội dung thành các vector mang đặc trưng ngữ nghĩa, giúp mô hình học máy nhận diện và phân loại dữ liệu như email, phản hồi khách hàng hoặc tin tức.
- Gom cụm nội dung: Dựa trên khoảng cách giữa các vector, hệ thống có thể nhóm những văn bản hoặc dữ liệu có nội dung tương tự vào cùng một cụm mà không cần xác định trước toàn bộ nhãn.
- Tìm kiếm đa phương thức: Phép nhúng có thể chuyển đổi văn bản, hình ảnh và âm thanh thành các vector đặc trưng, cho phép hệ thống tìm kiếm thông tin giữa nhiều loại dữ liệu.
- Phát hiện bất thường: Được dùng để tìm các dữ liệu lệch khỏi nhóm thông thường. Nếu một vector nằm xa các cụm vector phổ biến, hệ thống có thể đánh dấu đó là bất thường.
- Làm bộ nhớ dài hạn cho AI Agent: Giúp AI agent lưu trữ và truy xuất thông tin theo ngữ nghĩa, thay vì phụ thuộc hoàn toàn vào cửa sổ ngữ cảnh của mô hình.
>>> Xem thêm: Natural Language Processing - NLP là gì? Cách hoạt động và ứng dụng thực tế
V. Ưu điểm và hạn chế của embeddings
Bên cạnh những lợi ích nổi bật, embeddings vẫn có một số hạn chế cần cân nhắc khi triển khai trong thực tế.
VI. Bật mí cách sử dụng embeddings đạt hiệu quả cao
Để khai thác tối đa sức mạnh của embeddings, cần lựa chọn mô hình phù hợp, chuẩn hóa dữ liệu và tối ưu quy trình tìm kiếm vector. Cụ thể:
- Chọn đúng mô hình: Mỗi mô hình có thế mạnh riêng, nên căn cứ vào mục tiêu sử dụng, khả năng hỗ trợ tiếng Việt, độ chính xác và tốc độ xử lý trước khi lựa chọn.
- Chuẩn hóa và làm sạch dữ liệu đầu vào: Nên làm sạch nội dung trước khi nhúng bằng các cách như loại bỏ ký tự lỗi, xử lý lỗi chính tả, chuẩn hóa thuật ngữ, loại bỏ nội dung trùng và cập nhật thông tin hết hạn.
- Tối ưu cách chia đoạn dữ liệu (Chunking): Cần điều chỉnh kích thước và độ chồng lặp giữa các đoạn dựa trên cấu trúc tài liệu, đồng thời giữ lại ngữ cảnh cần thiết để tránh làm mất ý nghĩa của nội dung.
- Đánh giá và Fine-tune (Tinh chỉnh) nếu cần: Các chỉ số như Precision@K, Recall@K hoặc MRR giúp đánh giá hiệu quả tìm kiếm. Nếu kết quả chưa đạt yêu cầu, bạn có thể điều chỉnh cấu hình hoặc fine-tune mô hình bằng dữ liệu phù hợp.
- Cân bằng giữa độ chính xác, tốc độ và chi phí: Nên thử nghiệm các mô hình trên cùng tập dữ liệu, so sánh chất lượng truy xuất, thời gian phản hồi và tài nguyên lưu trữ để lựa chọn giải pháp đáp ứng tốt nhu cầu sử dụng.
VII. Một số câu hỏi thường gặp
1. Embeddings khác gì với vector?
Vector là một dãy số biểu diễn dữ liệu trong không gian toán học, còn embeddings là các vector được tạo ra để biểu diễn đặc trưng hoặc ý nghĩa của dữ liệu như văn bản, hình ảnh và âm thanh.
2. Embeddings có phải là AI không?
Nhúng không phải một hệ thống AI độc lập mà là phương pháp biểu diễn dữ liệu thường được tạo bởi các mô hình máy học hoặc trí tuệ nhân tạo.
3. Embedding khác mã hóa dữ liệu thông thường thế nào?
Mã hóa thông thường chủ yếu chuyển dữ liệu sang một dạng biểu diễn có thể lưu trữ hoặc truyền tải. Phương pháp nhúng nhằm thể hiện đặc trưng, quan hệ hoặc ý nghĩa để mô hình có thể so sánh và xử lý.
4. Embeddings có giống từ khóa không?
Không. Từ khóa là những từ hoặc cụm từ cụ thể được sử dụng để mô tả chủ đề hay nhu cầu tìm kiếm, trong khi embedding biểu diễn ý nghĩa của dữ liệu dưới dạng vector số và thường phản ánh cả ngữ cảnh, chủ đề hoặc quan hệ ngữ nghĩa.
5. Embeddings có ảnh hưởng đến SEO không?
Embeddings có liên quan đến cách các hệ thống tìm kiếm và AI xử lý ý nghĩa nội dung, nhưng không nên xem đây là một yếu tố SEO độc lập. Người làm SEO nên tập trung vào nội dung hữu ích, chính xác và đáp ứng đúng nhu cầu tìm kiếm.
6. Có thể tự tạo embeddings không?
Có. Bạn có thể sử dụng API embedding, mô hình mã nguồn mở hoặc hạ tầng AI riêng. Lựa chọn phụ thuộc vào ngân sách, dữ liệu, yêu cầu bảo mật và mục tiêu triển khai.
7. Embedding model nào phù hợp cho tiếng Việt?
Việc lựa chọn mô hình nhúng cho tiếng Việt phụ thuộc vào loại dữ liệu, lĩnh vực ứng dụng, ngân sách và yêu cầu hiệu năng. Bạn có thể cân nhắc các mô hình đa ngôn ngữ như BGE-M3, multilingual-e5 hoặc những mô hình được thiết kế chuyên biệt cho tiếng Việt; sau đó đánh giá thực tế để so sánh chất lượng.
Lời kết
Hy vọng qua bài viết, bạn đã hiểu embeddings là gì, cách công nghệ này hoạt động và vai trò trong các ứng dụng AI. Để triển khai hiệu quả, hãy lựa chọn mô hình phù hợp, tối ưu dữ liệu đầu vào và cân đối chi phí vận hành. Đây là nền tảng giúp khai thác dữ liệu tốt hơn và phát triển các giải pháp AI thiết thực.
 Tầng 4, Tòa 97–99 Láng Hạ, Phường Đống Đa, Thành phố Hà Nội
 Điện thoại:
 Mail: sales@nhanhoa.com
 Phản ánh chất lượng dịch vụ: