



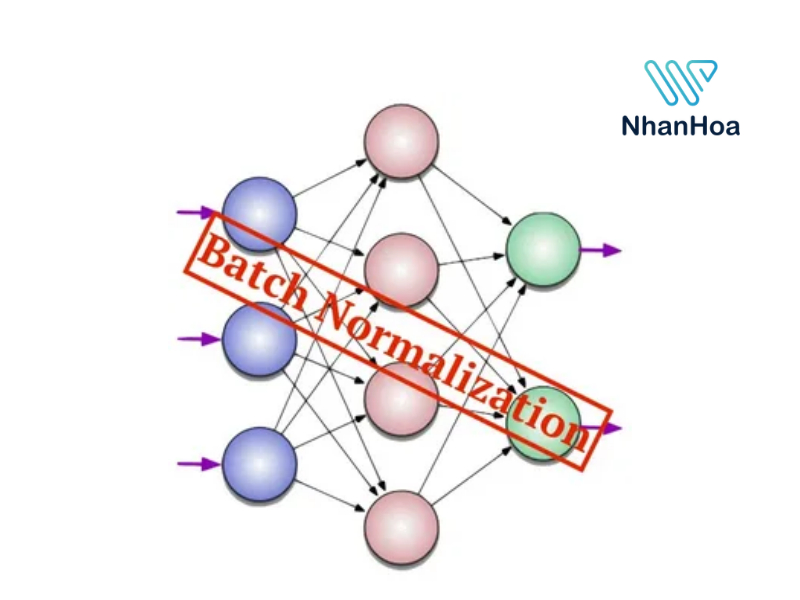
Batch Normalization là kỹ thuật chuẩn hóa được sử dụng trong Deep Learning nhằm hỗ trợ quá trình huấn luyện mạng nơ-ron ổn định và hiệu quả hơn. Vậy công nghệ này hoạt động như thế nào, có tác dụng gì và khi nào nên sử dụng? Cùng Nhân Hòa tìm hiểu chi tiết trong bài viết dưới đây.
Batch Normalization là gì?
Batch Normalization (BatchNorm hay chuẩn hóa theo lô) là kỹ thuật được giới thiệu trong nghiên cứu của Sergey Ioffe và Christian Szegedy vào năm 2015. Đây là một kỹ thuật trong Deep Learning, giúp tự động chuẩn hóa dữ liệu đầu vào của các tầng ẩn (hidden layers) theo từng nhóm nhỏ (mini-batch) trong quá trình huấn luyện.
Trong quá trình huấn luyện, mạng nơ-ron liên tục cập nhật trọng số để cải thiện khả năng dự đoán. Những thay đổi này dễ khiến các giá trị kích hoạt biến động, làm quá trình tối ưu trở nên khó khăn. BatchNorm giúp kiểm soát các giá trị đó, hỗ trợ quá trình huấn luyện.
>>> Xem thêm: Deep learning (Học sâu) là gì? Ứng dụng thực tế và xu hướng 2026
Nguyên lý hoạt động của Batch Normalization là gì?
Batch Normalization chuẩn hóa các giá trị kích hoạt trong mạng nơ-ron dựa trên thống kê của mini-batch, sau đó điều chỉnh chúng bằng hai tham số có thể học là (gamma) và (beta). Quá trình này gồm ba bước chính:
- Tính giá trị trung bình và phương sai: Xác định mean và variance của các giá trị kích hoạt trong mini-batch.
- Chuẩn hóa dữ liệu: Trừ mỗi giá trị cho trung bình rồi chia cho căn bậc hai của phương sai cộng với hằng số nhỏ (epsilon), giúp ổn định phép tính.
- Co giãn và dịch chuyển: Sử dụng hai tham số (gamma) và (beta) để điều chỉnh giá trị sau chuẩn hóa, giúp mạng duy trì khả năng biểu diễn đặc trưng.
Trong quá trình huấn luyện, BN sử dụng thống kê của mini-batch và cập nhật các giá trị trung bình, phương sai tích lũy. Khi suy luận, mô hình thường dùng các thống kê tích lũy này để chuẩn hóa dữ liệu.
Các phương pháp chuẩn hóa liên quan đến Batch Normalization
Ngoài Batch Normalization, Deep Learning còn sử dụng Layer Normalization, Group Normalization và Instance Normalization. Điểm khác biệt chính giữa các phương pháp là cách chia dữ liệu để tính giá trị trung bình và phương sai trước khi chuẩn hóa.
Layer Normalization (LayerNorm)
LayerNorm chuẩn hóa các đặc trưng trong từng mẫu dữ liệu, thay vì tính thống kê trên nhiều mẫu trong một mini-batch. Vì vậy, kết quả không phụ thuộc vào số lượng mẫu được đưa vào cùng lúc.
Ví dụ: Trong mô hình Transformer xử lý văn bản, LayerNorm chuẩn hóa các giá trị đặc trưng của từng biểu diễn đầu vào. Phương pháp này phù hợp với các mô hình xử lý ngôn ngữ và dữ liệu chuỗi.
Group Normalization (GroupNorm)
GroupNorm chia các kênh đặc trưng của một mẫu thành nhiều nhóm, sau đó tính trung bình và phương sai riêng cho từng nhóm để chuẩn hóa.
Ví dụ: Khi huấn luyện mô hình nhận diện hình ảnh với batch size nhỏ do giới hạn bộ nhớ GPU, thống kê của BatchNorm có thể thiếu ổn định. GroupNorm giảm sự phụ thuộc vào kích thước batch bằng cách tính thống kê trên các nhóm kênh của từng mẫu.
Instance Normalization (InstanceNorm)
InstanceNorm chuẩn hóa từng kênh đặc trưng riêng biệt trong mỗi mẫu dữ liệu. Khác với GroupNorm, phương pháp này không gộp nhiều kênh thành nhóm để tính thống kê.
Ví dụ: Trong bài toán chuyển đổi phong cách hình ảnh, InstanceNorm giúp điều chỉnh đặc trưng của ảnh đầu vào, hỗ trợ mô hình tạo ra hình ảnh mang phong cách mong muốn.
Ưu điểm và hạn chế của mô hình chuẩn hóa theo lô
Batch Normalization giúp quá trình huấn luyện mô hình Deep Learning ổn định hơn, nhưng hiệu quả còn phụ thuộc vào kiến trúc mạng và cách tổ chức dữ liệu. Bảng dưới đây tổng hợp các ưu điểm và hạn chế chính của kỹ thuật này.
>>> Xem thêm: Overfitting là gì? Nguyên nhân, dấu hiệu và cách khắc phục
Phân biệt Batch Normalization với Layer Normalization và Dropout
Khi xây dựng các mô hình Deep Learning, người mới rất dễ bị nhầm lẫn giữa ba khái niệm: Batch Normalization, Layer Normalization và Dropout.
Mặc dù cả ba kỹ thuật này đều được chèn vào giữa các lớp ẩn để giúp mô hình học tốt hơn và giảm Overfitting, nhưng nguyên lý hoạt động và bản chất của chúng hoàn toàn khác nhau. Dưới đây là bảng so sánh tổng quan 3 mô hình này.
>>> Xem thêm: Learning Rate là gì? 4 cách tính tốc độ học trong học máy
[FAQs] Câu hỏi thường gặp về Batch Normalization
Batch Normalization có giúp giảm overfitting không?
BatchNorm có thể tạo tác động điều chuẩn nhất định, nhưng không bảo đảm ngăn chặn overfitting. Tùy trường hợp, có thể kết hợp thêm tăng cường dữ liệu hoặc Dropout.
BatchNorm nên đặt trước hay sau hàm kích hoạt?
Một cấu hình phổ biến trong CNN là Convolution → BatchNorm → ReLU. Tuy nhiên, thứ tự có thể thay đổi tùy kiến trúc và thiết kế mô hình.
Chuẩn hóa theo lô khác gì với chuẩn hóa dữ liệu đầu vào?
Chuẩn hóa dữ liệu đầu vào được thực hiện trước khi đưa dữ liệu vào mô hình, còn BatchNorm thường chuẩn hóa các giá trị kích hoạt bên trong mạng nơ-ron. Hai kỹ thuật có thể được sử dụng đồng thời.
Kết luận
Batch Normalization là kỹ thuật quan trọng trong Deep Learning, giúp kiểm soát các giá trị kích hoạt và hỗ trợ quá trình huấn luyện mạng nơ-ron. Tuy nhiên, hiệu quả còn phụ thuộc vào kiến trúc mô hình, batch size và đặc điểm dữ liệu. Hiểu rõ nguyên lý và giới hạn của BatchNorm sẽ giúp người học lựa chọn phương pháp phù hợp khi xây dựng mô hình AI.

 Tầng 4, Tòa 97–99 Láng Hạ, Phường Đống Đa, Thành phố Hà Nội
 Điện thoại:
 Mail: sales@nhanhoa.com
 Phản ánh chất lượng dịch vụ: