



Văn bản, hình ảnh và âm thanh có cấu trúc khác nhau, nhưng đều có thể được biểu diễn dưới dạng số để AI xử lý. Encoder đảm nhiệm quá trình chuyển đổi này thông qua các kỹ thuật mã hóa dữ liệu. Tìm hiểu Encoder trong AI là gì sẽ giúp bạn hiểu rõ hơn về cơ chế vận hành của các mô hình học máy.
Encoder trong AI là gì?
Trong trí tuệ nhân tạo (AI) và học máy (Machine Learning), Encoder (bộ mã hóa) là thành phần chuyển đổi dữ liệu đầu vào thô như văn bản, hình ảnh và âm thanh thành các biểu diễn số hoặc vector đặc trưng (embedding) để mô hình có thể phân tích và xử lý thông tin. Quá trình này giúp trích xuất những đặc trưng quan trọng, làm cơ sở cho các tác vụ AI tiếp theo.
Tùy theo kiến trúc và mục tiêu sử dụng, Encoder có thể tạo ra biểu diễn dữ liệu phục vụ các tác vụ như phân loại, nhận diện hình ảnh và tìm kiếm ngữ nghĩa. Trong kiến trúc Encoder–Decoder, Encoder mã hóa dữ liệu đầu vào, còn Decoder sử dụng thông tin này để tạo ra kết quả đầu ra.
>>> Xem thêm: Khác biệt giữa Machine Learning với Deep Learning
Các bộ mã hóa của Encoder
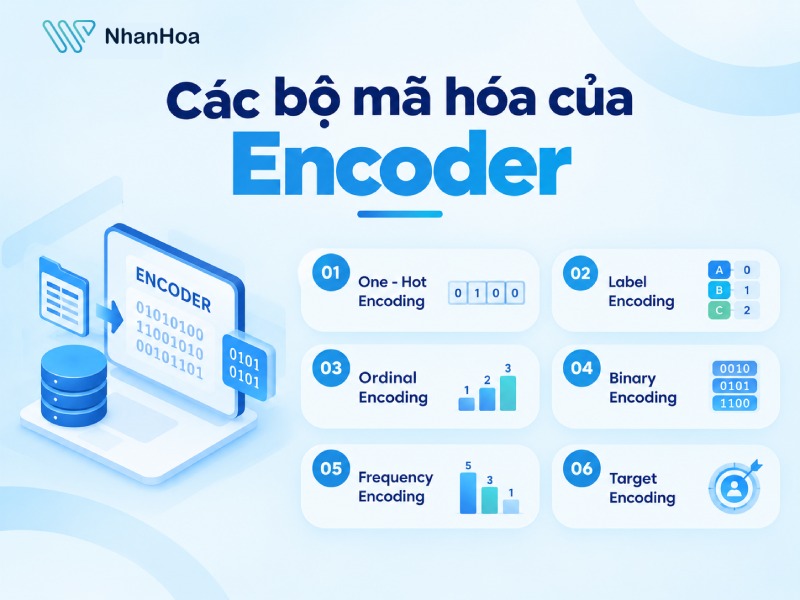
Trong Machine Learning, Encoding chuyển dữ liệu danh mục như màu sắc, thương hiệu, thành phố thành dạng số để mô hình xử lý. Tùy đặc điểm dữ liệu và thuật toán, có thể áp dụng các phương pháp mã hóa khác nhau.
One - Hot Encoding
One-Hot Encoding biểu diễn mỗi danh mục bằng một cột nhị phân riêng, trong đó giá trị 1 thể hiện danh mục xuất hiện và 0 thể hiện danh mục không xuất hiện. Ví dụ, ba màu đỏ, xanh dương và xanh lá được mã hóa thành các vector [1, 0, 0], [0, 1, 0] và [0, 0, 1].
Phương pháp này không tạo ra thứ tự giả giữa các danh mục, phù hợp với dữ liệu không có thứ bậc như màu sắc, loại sản phẩm hoặc ngành nghề. Tuy nhiên, số lượng cột có thể tăng đáng kể khi dữ liệu chứa nhiều danh mục khác nhau.
Label Encoding
Label Encoding gán một số nguyên riêng cho mỗi danh mục. Chẳng hạn, màu đỏ được mã hóa thành 0, xanh dương thành 1 và xanh lá thành 2.
Ưu điểm của phương pháp này là đơn giản, tiết kiệm bộ nhớ và dễ triển khai. Tuy nhiên, các giá trị số có thể khiến một số thuật toán hiểu nhầm rằng các danh mục có thứ tự hoặc khoảng cách định lượng. Vì vậy, Label Encoding thường phù hợp hơn với nhãn mục tiêu hoặc một số mô hình dựa trên cây quyết định.
Ordinal Encoding
Ordinal Encoding chuyển các danh mục thành số nguyên theo thứ tự vốn có của chúng. Ví dụ, trình độ học vấn có thể được mã hóa lần lượt thành 0, 1, 2 và 3, tương ứng với trung học phổ thông, cử nhân, thạc sĩ và tiến sĩ.
Khác với Label Encoding thông thường, phương pháp này chủ động giữ lại thứ bậc có ý nghĩa trong dữ liệu. Ordinal Encoding phù hợp với các biến như mức độ hài lòng, cấp độ dịch vụ hoặc trình độ học vấn.
Binary Encoding
Binary Encoding chuyển mỗi danh mục thành một số nguyên, sau đó biểu diễn số đó dưới dạng nhị phân và tách từng bit thành một cột dữ liệu.
Ví dụ, với 8 danh mục, One-Hot Encoding cần 8 cột, trong khi Binary Encoding chỉ cần 3 cột vì 23=8. Nhờ đó, phương pháp này giúp giảm số lượng đặc trưng khi xử lý dữ liệu có nhiều danh mục, dù cách biểu diễn nhị phân có thể khó diễn giải hơn.
Frequency Encoding
Frequency Encoding thay mỗi danh mục bằng số lần xuất hiện hoặc tỷ lệ xuất hiện của danh mục đó trong tập dữ liệu. Chẳng hạn, một thương hiệu xuất hiện trong 30% bản ghi có thể được mã hóa thành 0,3.
Phương pháp này giúp biểu diễn dữ liệu gọn hơn mà không cần tạo nhiều cột mới. Frequency Encoding thường hữu ích với các biến có số lượng danh mục lớn, nhưng có thể khiến những danh mục khác nhau có cùng giá trị mã hóa nếu chúng có tần suất giống nhau.
Target Encoding
Target Encoding thay mỗi danh mục bằng giá trị thống kê của biến mục tiêu tương ứng. Với bài toán dự đoán khách hàng không thanh toán khoản vay, mỗi thành phố có thể được mã hóa dựa trên tỷ lệ khách hàng từng không thanh toán tại đó.
Phương pháp này giúp mô hình khai thác mối liên hệ giữa danh mục và kết quả cần dự đoán, đặc biệt với dữ liệu có nhiều giá trị khác nhau. Tuy nhiên, cần kiểm soát rò rỉ dữ liệu và hiện tượng quá khớp bằng các kỹ thuật như tính toán thống kê trên tập huấn luyện hoặc sử dụng cross-validation phù hợp.
>>> Xem thêm: Data Labeling là gì? Cách dữ liệu gán nhãn thúc đẩy AI phát triển
Vai trò của Encoder
Encoder đóng vai trò chuyển đổi dữ liệu đầu vào thành biểu diễn số, giúp mô hình AI trích xuất đặc trưng và nắm bắt thông tin quan trọng để thực hiện các tác vụ như phân loại, dự đoán hoặc tạo dữ liệu.
Các vai trò chính gồm:
- Trích xuất đặc trưng: Nhận diện những thông tin quan trọng từ văn bản, hình ảnh, âm thanh hoặc dữ liệu dạng chuỗi.
- Tạo biểu diễn dữ liệu: Chuyển dữ liệu thành vector đặc trưng hoặc biểu diễn tiềm ẩn để mô hình dễ phân tích và học các mối quan hệ.
- Giảm chiều dữ liệu: Trong các kiến trúc phù hợp như AutoEncoder, Encoder nén dữ liệu thành biểu diễn gọn hơn, hỗ trợ giảm độ phức tạp khi xử lý.
- Nắm bắt ngữ cảnh: Với Transformer Encoder, cơ chế Self-Attention giúp mô hình xác định mối quan hệ giữa các phần tử trong dữ liệu đầu vào.
- Hỗ trợ các tác vụ AI: Cung cấp biểu diễn đầu vào cho các nhiệm vụ như phân loại văn bản, nhận diện hình ảnh, tìm kiếm ngữ nghĩa và phát hiện bất thường.
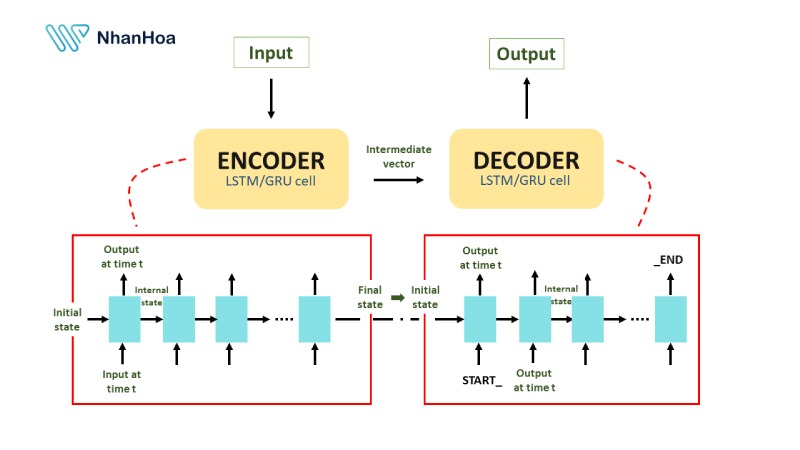
Phân biệt giữa Encoder và Decoder
Encoder và Decoder đảm nhiệm hai vai trò khác nhau nhưng bổ trợ cho nhau trong kiến trúc AI. Encoder tập trung phân tích dữ liệu và xây dựng biểu diễn ngữ cảnh, trong khi Decoder sử dụng thông tin đó để tạo đầu ra. Các khác biệt chính được thể hiện qua bảng sau.
Kinh nghiệm từ Nhân Hòa: Cần lựa chọn kiến trúc Encoder, Decoder hoặc Encoder-Decoder dựa trên mục tiêu xử lý, đồng thời đánh giá độ chính xác, độ trễ và chi phí tính toán để bảo đảm hiệu quả triển khai thực tế.
Ứng dụng nổi bật của Encoder trong Machine Learning và AI
Các ứng dụng nổi bật của Encoder trong Machine Learning và AI tập trung vào năm lĩnh vực chính: xử lý ngôn ngữ tự nhiên, thị giác máy tính, nhận dạng giọng nói, phát hiện bất thường và AI tạo sinh.
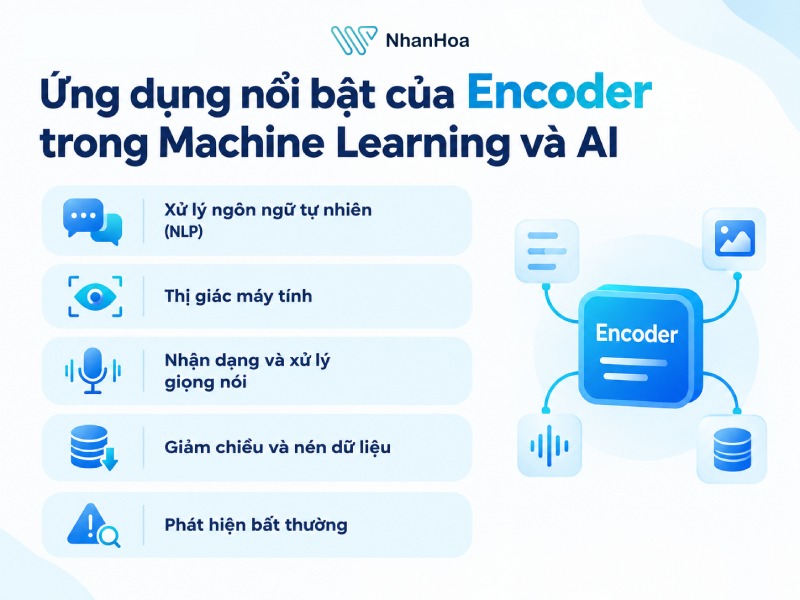
Xử lý ngôn ngữ tự nhiên (NLP)
Encoder chuyển đổi văn bản thành vector đặc trưng, giúp mô hình nhận diện ngữ cảnh và mối quan hệ giữa các từ. Ứng dụng tiêu biểu gồm phân loại văn bản, phân tích cảm xúc, tìm kiếm ngữ nghĩa và hỏi đáp. BERT là một ví dụ sử dụng Transformer Encoder để học biểu diễn ngữ cảnh.
Thị giác máy tính (Computer Vision)
CNN Encoder và Transformer Encoder trích xuất đặc trưng từ hình ảnh, video như hình dạng, kết cấu và mối quan hệ giữa các vùng ảnh. Những biểu diễn này phục vụ các tác vụ phân loại hình ảnh, nhận diện đối tượng và phân đoạn ảnh.
Nhận dạng và xử lý giọng nói
Encoder mã hóa tín hiệu âm thanh thành biểu diễn số để mô hình phân tích nội dung và đặc điểm giọng nói. Công nghệ này được ứng dụng trong nhận dạng giọng nói, chuyển giọng nói thành văn bản, phân loại âm thanh và nhận diện người nói.
Giảm chiều và nén dữ liệu
Trong AutoEncoder, Encoder nén dữ liệu thành biểu diễn tiềm ẩn có kích thước nhỏ gọn hơn, còn Decoder tái tạo dữ liệu ban đầu. Cách tiếp cận này hỗ trợ giảm chiều dữ liệu, khử nhiễu và giảm lượng thông tin cần xử lý.
Phát hiện bất thường
Encoder giúp mô hình học đặc trưng của dữ liệu thông thường. Khi kết hợp với Decoder trong AutoEncoder, hệ thống có thể phát hiện những mẫu có sai lệch tái tạo lớn, phục vụ nhận diện giao dịch đáng ngờ, lỗi thiết bị hoặc hoạt động bất thường.
>>> Xem thêm: Multi Agent System là gì? Cách AI đa tác nhân xử lý tác vụ phức tạp
Thách thức của Encoder trong các kỹ thuật mã hóa
Encoder vẫn tồn tại một số thách thức về chất lượng dữ liệu, khả năng giữ thông tin và chi phí tính toán, ảnh hưởng đến hiệu quả của mô hình AI.
- Mất thông tin quan trọng: Khi nén dữ liệu thành biểu diễn có số chiều nhỏ hơn, Encoder có thể làm mất những đặc trưng cần thiết cho tác vụ. Điều này ảnh hưởng đến độ chính xác của quá trình phân loại, dự đoán hoặc tái tạo dữ liệu.
- Phụ thuộc vào chất lượng dữ liệu: Dữ liệu huấn luyện thiếu đa dạng, chứa nhiều nhiễu hoặc không đại diện cho dữ liệu thực tế có thể khiến Encoder học các đặc trưng sai lệch, làm giảm hiệu quả xử lý.
- Chi phí tính toán cao: Các kiến trúc phức tạp như Transformer Encoder có thể cần nhiều bộ nhớ, năng lực xử lý và thời gian huấn luyện, gây khó khăn khi triển khai trên thiết bị có tài nguyên hạn chế.
- Khó diễn giải biểu diễn: Encoder tạo ra các vector đặc trưng nhiều chiều, khiến việc xác định ý nghĩa của từng thành phần và giải thích cách mô hình dự đoán trở nên khó khăn.
- Hạn chế khả năng khái quát hóa: Encoder có thể hoạt động kém với dữ liệu mới khác biệt so với tập huấn luyện, đòi hỏi đánh giá, điều chỉnh hoặc huấn luyện bổ sung để duy trì hiệu quả.
[FAQs] Các câu hỏi thường gặp về Encoder
Encoder có bắt buộc phải đi cùng Decoder không?
Không. Một số mô hình chỉ sử dụng Encoder để trích xuất đặc trưng hoặc phân loại dữ liệu, trong khi mô hình Decoder-only có thể tạo văn bản mà không cần một Encoder riêng biệt.
Khi nào nên sử dụng One-Hot Encoding?
One-Hot Encoding phù hợp với dữ liệu danh mục không có thứ tự tự nhiên như màu sắc, thương hiệu hoặc quốc gia, đặc biệt khi số lượng danh mục không quá lớn.
Label Encoding khác Ordinal Encoding như thế nào?
Label Encoding thường chuyển nhãn thành số, còn Ordinal Encoding mã hóa đặc trưng theo thứ tự có ý nghĩa, chẳng hạn thấp, trung bình và cao.
Có thể kết hợp nhiều phương pháp Encoding trong một mô hình không?
Có. Có thể áp dụng các phương pháp khác nhau cho từng đặc trưng tùy theo loại dữ liệu và thuật toán, chẳng hạn One-Hot Encoding cho thương hiệu và Ordinal Encoding cho mức độ hài lòng.
Random Forest có cần Encoding không?
Có, nếu dữ liệu danh mục ở dạng văn bản và mô hình không hỗ trợ xử lý trực tiếp. Với Random Forest trong scikit-learn, cần mã hóa dữ liệu thành dạng số trước khi huấn luyện
Lời kết
Cùng với sự phát triển của AI, Encoder tiếp tục giữ vai trò quan trọng trong việc biểu diễn và xử lý dữ liệu. Nắm vững nguyên lý hoạt động và các ứng dụng của Encoder sẽ tạo nền tảng để bạn tìm hiểu sâu hơn về những kiến trúc AI hiện đại.


 Tầng 4, Tòa 97–99 Láng Hạ, Phường Đống Đa, Thành phố Hà Nội
 Điện thoại:
 Mail: sales@nhanhoa.com
 Phản ánh chất lượng dịch vụ: