



Để AI đưa ra dự đoán từ hình ảnh, văn bản hay âm thanh, dữ liệu cần được gắn nhãn phù hợp với mục tiêu huấn luyện. Tìm hiểu Data Labeling là gì để làm rõ phương pháp, quy trình và vai trò của kỹ thuật này trong phát triển AI.
Data Labeling là gì?
Data Labeling (gán nhãn dữ liệu) là quá trình nhận diện, phân loại và gắn thẻ (tag) hoặc thông tin mô tả vào dữ liệu thô như hình ảnh, văn bản, âm thanh và video. Quá trình này cung cấp ngữ cảnh cần thiết để các mô hình trí tuệ nhân tạo (AI) và học máy (Machine Learning) học hỏi đặc trưng, nhận diện mẫu và đưa ra dự đoán hoặc phân loại chính xác khi tiếp nhận dữ liệu mới.
Ví dụ, trong hệ thống nhận diện hình ảnh, dữ liệu được gắn nhãn “mèo” hoặc “chó” để mô hình AI học cách phân biệt hai loài vật. Chất lượng dữ liệu gán nhãn ảnh hưởng trực tiếp đến hiệu quả huấn luyện và khả năng dự đoán của mô hình.
>>> Xem thêm: Khác biệt giữa Machine Learning với Deep Learning
Các loại Data Labeling phổ biến
Data Labeling được phân loại theo dữ liệu và mục tiêu AI, phổ biến gồm gán nhãn hình ảnh, văn bản, âm thanh và video. Mỗi loại sử dụng kỹ thuật riêng để giúp AI nhận diện và xử lý dữ liệu chính xác hơn.
Xử lý ngôn ngữ tự nhiên (Natural Language Processing - NLP)
Gán nhãn văn bản là quá trình đánh dấu, phân loại dữ liệu ngôn ngữ theo các tiêu chí cụ thể để mô hình AI có thể hiểu ngữ cảnh và ý nghĩa của nội dung. Một số tác vụ phổ biến gồm phân tích cảm xúc, nhận diện thực thể như tên người và địa điểm, phân loại chủ đề, xác định ý định người dùng và gán nhãn từ loại.
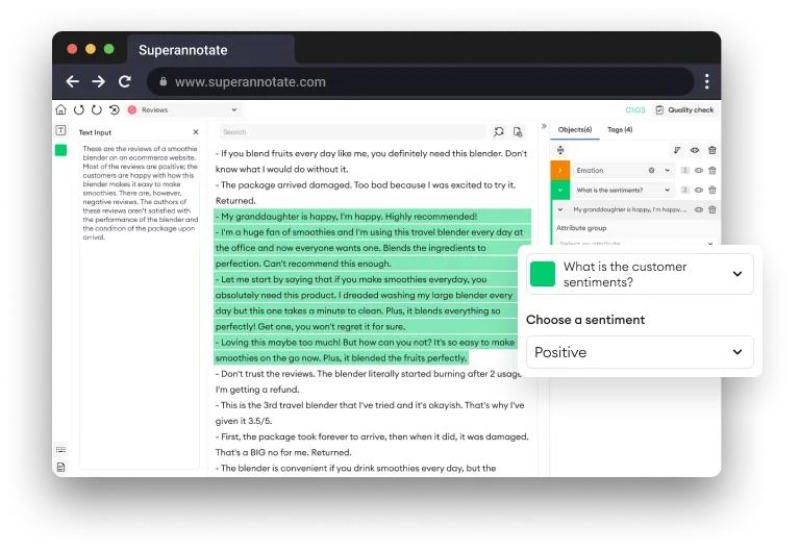
Dữ liệu sau khi gán nhãn được sử dụng để huấn luyện các mô hình xử lý ngôn ngữ tự nhiên (NLP), phục vụ chatbot, phân tích phản hồi khách hàng, tìm kiếm thông tin và dịch máy.
Thị giác máy tính (Computer Vision)
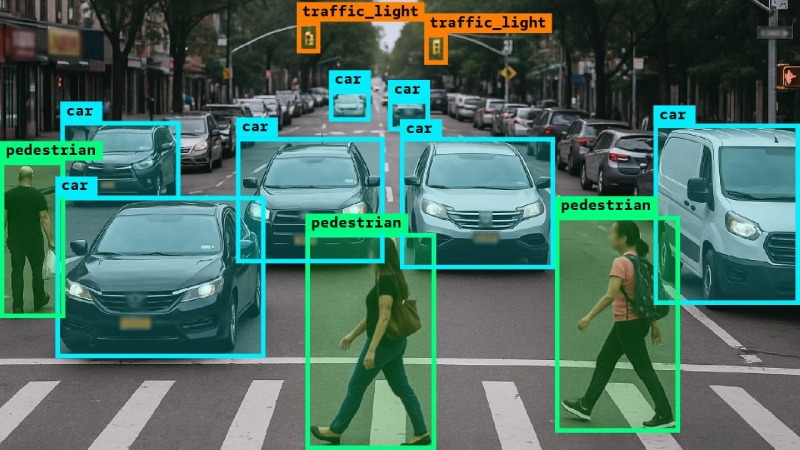
Loại Data Labeling này tập trung vào việc xác định và đánh dấu các đối tượng, đặc điểm hoặc hành động trong hình ảnh và video. Các phương pháp thường dùng gồm phân loại hình ảnh, vẽ khung giới hạn, đánh dấu điểm đặc trưng, phân đoạn ảnh theo pixel và theo dõi đối tượng qua từng khung hình video.
Dữ liệu được gán nhãn giúp huấn luyện mô hình thị giác máy tính (Computer Vision) phục vụ nhận diện sản phẩm, kiểm tra lỗi trong sản xuất, phân tích video giám sát và phát triển phương tiện tự hành.
Xử lý âm thanh (Audio Processing)
Gán nhãn âm thanh là quá trình chuyển đổi hoặc phân loại dữ liệu âm thanh thành thông tin có cấu trúc. Công việc có thể bao gồm phiên âm giọng nói thành văn bản, xác định người nói, đánh dấu thời điểm phát âm, nhận diện cảm xúc trong giọng nói hoặc phân loại âm thanh môi trường như tiếng còi, tiếng động vật và tiếng máy móc.
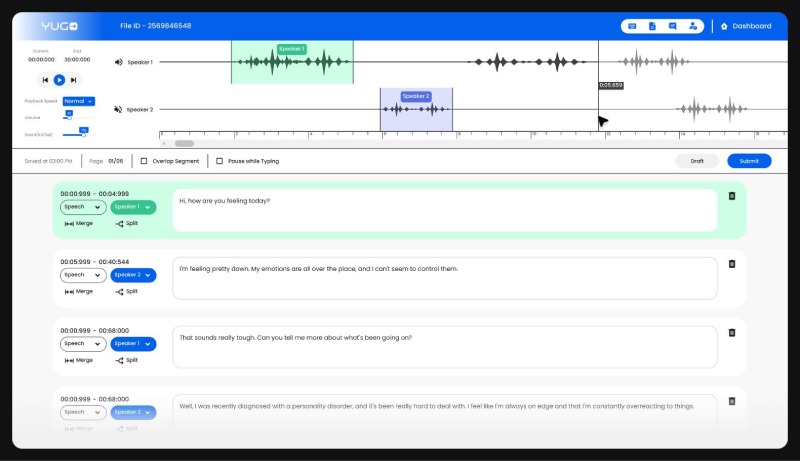
Dữ liệu này được sử dụng để phát triển hệ thống nhận dạng giọng nói, chuyển giọng nói thành văn bản, trợ lý ảo và các ứng dụng phân tích cuộc gọi.
Gán nhãn dữ liệu đa phương thức (Multimodal Labeling)
Gán nhãn dữ liệu đa phương thức là quá trình kết hợp và liên kết nhãn giữa nhiều loại dữ liệu như văn bản, hình ảnh, video và âm thanh. Chẳng hạn, một video có thể được gán nhãn đồng thời bằng bản phiên âm hội thoại, vị trí người nói trong khung hình và thời điểm diễn ra hành động.
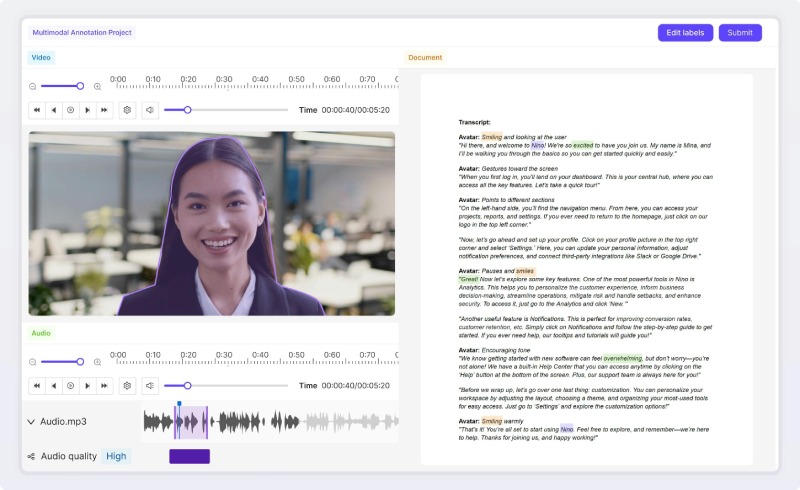
Phương pháp này hỗ trợ huấn luyện các mô hình AI có khả năng phân tích đồng thời nhiều nguồn thông tin, ứng dụng trong tìm kiếm video thông minh, nhận diện hành động và phát triển trợ lý AI đa phương thức.
>>> Xem thêm: Cline AI là gì? Các tính năng lõi để tự động hóa lập trình
Quy trình Data Labeling cơ bản như thế nào?
Quy trình Data Labeling (gán nhãn dữ liệu) thường gồm 6 bước, từ thu thập dữ liệu đến kiểm tra và hoàn thiện bộ dữ liệu phục vụ huấn luyện mô hình AI/ML.
- Bước 1: Thu thập dữ liệu: Tập hợp dữ liệu văn bản, hình ảnh, video hoặc âm thanh phù hợp với mục tiêu huấn luyện, đồng thời đảm bảo nguồn dữ liệu đáng tin cậy và có quyền sử dụng hợp pháp.
- Bước 2: Làm sạch và chuẩn bị dữ liệu: Loại bỏ dữ liệu trùng lặp, sai định dạng hoặc không liên quan; chuẩn hóa dữ liệu để thuận tiện cho quá trình gán nhãn.
- Bước 3: Xây dựng tiêu chuẩn gán nhãn: Xác định hệ thống nhãn, quy tắc phân loại và hướng dẫn cụ thể nhằm đảm bảo tính nhất quán giữa những người thực hiện.
- Bước 4: Tiến hành gán nhãn: Người gán nhãn hoặc công cụ tự động phân loại, đánh dấu dữ liệu theo tiêu chuẩn đã thiết lập. Ví dụ, văn bản được gán nhãn cảm xúc, hình ảnh được khoanh vùng đối tượng hoặc âm thanh được phiên âm thành văn bản.
- Bước 5: Kiểm tra chất lượng: Rà soát kết quả để phát hiện nhãn sai, dữ liệu thiếu hoặc không nhất quán. Những nhãn chưa đạt yêu cầu cần được chỉnh sửa hoặc chuyển cho chuyên gia kiểm duyệt.
- Bước 6: Hoàn thiện và xuất dữ liệu: Chuẩn hóa kết quả, lưu trữ theo định dạng phù hợp và bàn giao bộ dữ liệu để huấn luyện, xác thực hoặc kiểm thử mô hình AI/ML.
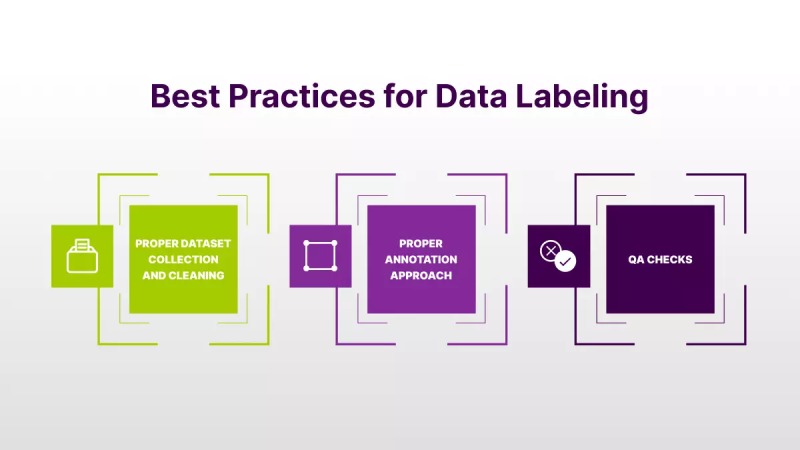
Lưu ý từ chuyên gia Nhân Hòa: Chất lượng Data Labeling phụ thuộc vào độ chính xác của nhãn và tính nhất quán trong quá trình thực hiện. Doanh nghiệp nên kết hợp tự động hóa với cơ chế Human-in-the-Loop (HITL), cho phép con người kiểm tra và hiệu chỉnh nhãn do máy tạo ra, nhằm hạn chế sai sót và nâng cao độ tin cậy của dữ liệu.
Các phương pháp gán nhãn dữ liệu
Doanh nghiệp có thể chọn gán nhãn thủ công, tự động hoặc bán tự động tùy theo quy mô dữ liệu, độ chính xác và nguồn lực.
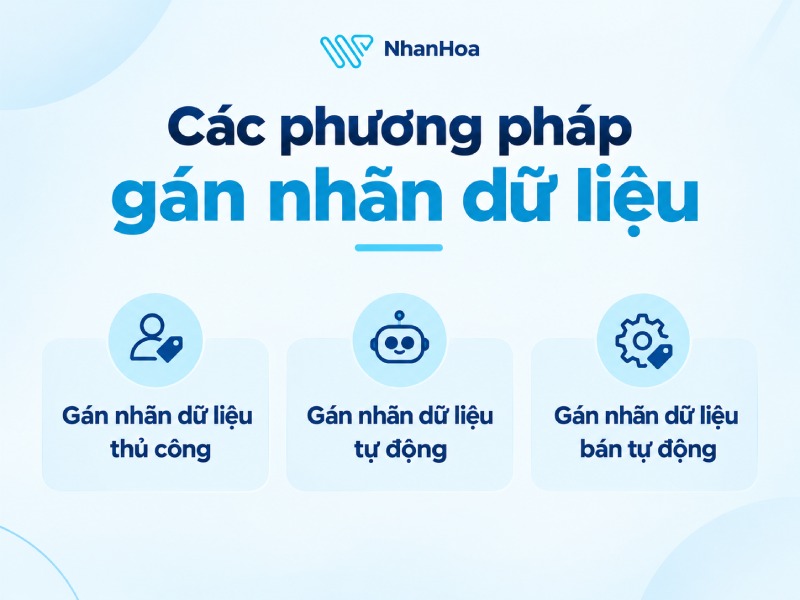
Gán nhãn dữ liệu thủ công (Manual Labeling)
Đây là phương pháp con người trực tiếp kiểm tra, phân loại và gắn nhãn cho từng mẫu dữ liệu theo bộ quy tắc đã xác định. Gán nhãn thủ công phù hợp với dữ liệu phức tạp, yêu cầu chuyên môn cao hoặc những trường hợp cần kiểm soát chặt chẽ chất lượng nhãn.
- Ưu điểm: Có thể xử lý các trường hợp khó và linh hoạt theo ngữ cảnh.
- Hạn chế: Tốn nhiều thời gian, nhân lực và chi phí khi xử lý tập dữ liệu lớn.
Gán nhãn dữ liệu tự động (Automated Labeling)
Phương pháp này sử dụng thuật toán, mô hình học máy hoặc AI để nhận diện đặc điểm và tự động gán nhãn cho dữ liệu dựa trên các quy tắc hoặc mẫu đã học. Cách tiếp cận này phù hợp với những tác vụ có tiêu chí rõ ràng và khối lượng dữ liệu lớn.
- Ưu điểm: Xử lý dữ liệu nhanh, giảm công sức thủ công và dễ mở rộng quy mô.
- Hạn chế: Có thể tạo ra nhãn sai hoặc thiếu nhất quán nếu mô hình chưa đủ chính xác hay dữ liệu đầu vào có nhiều trường hợp ngoại lệ. Vì vậy, kết quả vẫn cần được đánh giá chất lượng.
Gán nhãn dữ liệu bán tự động (Semi-automated Labeling)
Gán nhãn bán tự động kết hợp khả năng xử lý của AI với sự kiểm tra và hiệu chỉnh của con người. Mô hình có thể đề xuất nhãn ban đầu, sau đó người gán nhãn xác nhận, sửa lỗi hoặc xử lý những trường hợp chưa rõ ràng.
- Ưu điểm: Cân bằng giữa tốc độ xử lý, chi phí và độ chính xác; giảm khối lượng công việc thủ công.
- Hạn chế: Vẫn cần nhân sự có chuyên môn để kiểm duyệt kết quả, đặc biệt với dữ liệu phức tạp hoặc nhãn do AI dự đoán chưa đáng tin cậy.
Công cụ Data Labeling phổ biến hiện nay
Các công cụ Data Labeling cung cấp nhiều tính năng hỗ trợ gán nhãn, quản lý và kiểm tra chất lượng dữ liệu. Mỗi nền tảng có thế mạnh riêng, phù hợp với từng loại dữ liệu và quy mô dự án AI.
Label Studio
Label Studio là nền tảng gán nhãn dữ liệu mã nguồn mở, hỗ trợ nhiều loại dữ liệu như văn bản, hình ảnh, âm thanh và video. Công cụ cho phép tùy chỉnh giao diện gán nhãn, thiết lập các loại chú thích và tích hợp mô hình học máy để hỗ trợ tự động hóa một phần quy trình. Sau khi hoàn tất, người dùng có thể xuất dữ liệu theo định dạng phù hợp để phục vụ huấn luyện và đánh giá mô hình AI.
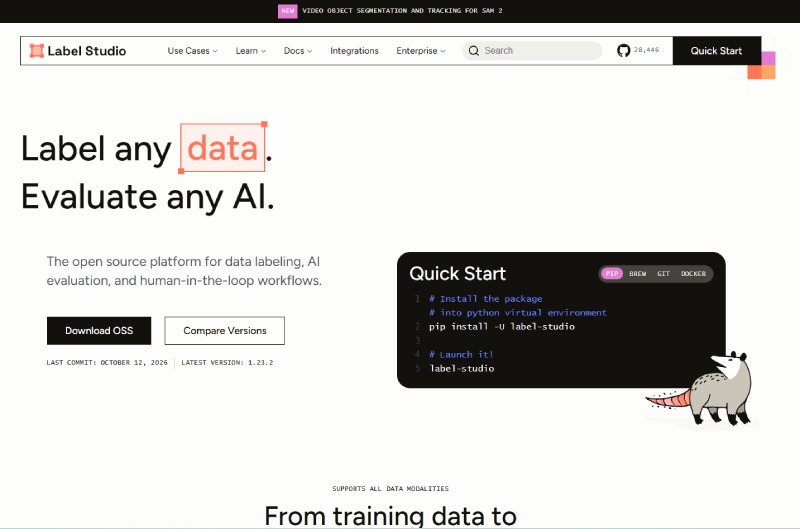
Nhờ khả năng tùy chỉnh linh hoạt, Label Studio phù hợp với các nhóm phát triển cần xử lý nhiều định dạng dữ liệu hoặc xây dựng quy trình gán nhãn theo yêu cầu riêng.
CVAT (Computer Vision Annotation Tool)
CVAT là công cụ chuyên dụng cho gán nhãn hình ảnh và video, được thiết kế để hỗ trợ các tác vụ thị giác máy tính. Nền tảng cung cấp các tính năng như phân loại hình ảnh, vẽ khung giới hạn (bounding box), phân đoạn ảnh và theo dõi đối tượng qua nhiều khung hình. Người dùng có thể tổ chức dự án, quản lý tác vụ và xuất kết quả để sử dụng trong quá trình huấn luyện mô hình.
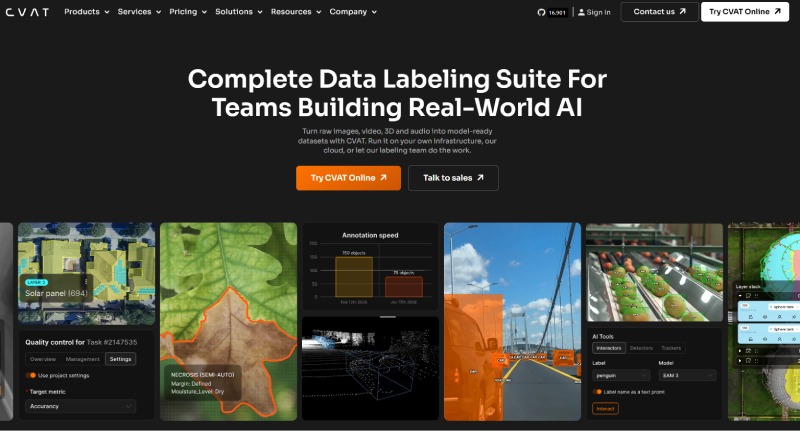
CVAT phù hợp với các dự án nhận diện vật thể, giám sát giao thông, phân tích video và kiểm tra lỗi sản phẩm bằng AI, đặc biệt khi cần xử lý số lượng lớn hình ảnh hoặc khung hình video.
Doccano
Doccano là nền tảng gán nhãn văn bản mã nguồn mở, tập trung vào các tác vụ xử lý ngôn ngữ tự nhiên (NLP). Công cụ hỗ trợ phân loại văn bản, nhận diện thực thể có tên và gán nhãn chuỗi dữ liệu. Người dùng có thể thiết lập nhãn, quản lý dữ liệu và phối hợp thực hiện các nhiệm vụ chú thích trên cùng một dự án.
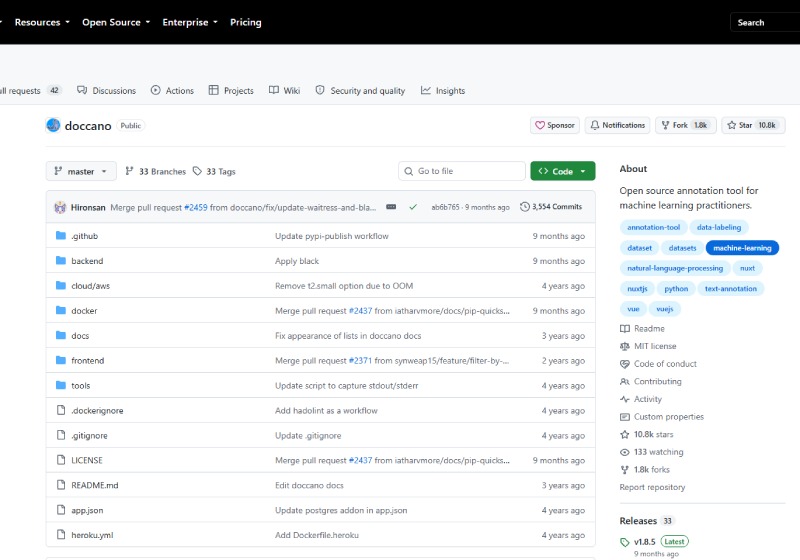
Với giao diện tương đối đơn giản, Doccano phù hợp để xây dựng bộ dữ liệu phục vụ chatbot, phân tích cảm xúc, phân loại nội dung và các ứng dụng hiểu ngôn ngữ tự nhiên. Đây cũng là lựa chọn đáng cân nhắc đối với nhóm phát triển cần một công cụ chuyên về văn bản mà không yêu cầu hệ thống gán nhãn quá phức tạp.
Labelbox
Labelbox là nền tảng quản lý và gán nhãn dữ liệu AI, hướng đến các dự án có quy mô lớn và quy trình làm việc chuyên nghiệp. Công cụ hỗ trợ tổ chức dữ liệu, phân công nhiệm vụ, phối hợp giữa các thành viên và đánh giá chất lượng nhãn. Ngoài ra, nền tảng còn cung cấp các tính năng hỗ trợ AI để tăng tốc quá trình chú thích và giảm khối lượng công việc thủ công.
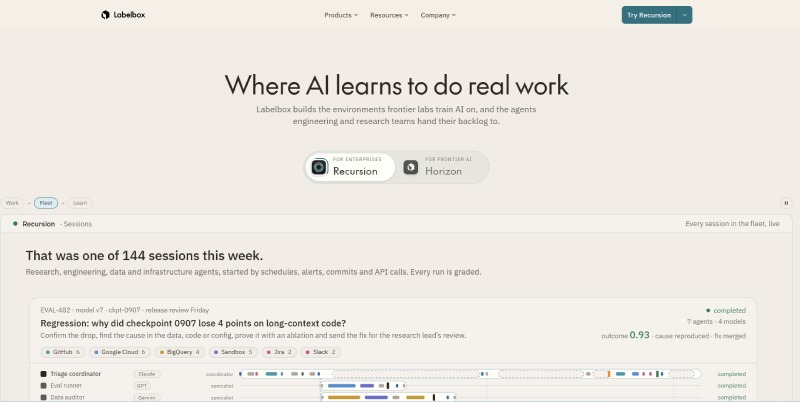
Labelbox phù hợp với doanh nghiệp cần quản lý nhiều bộ dữ liệu, phối hợp giữa đội ngũ gán nhãn và chuyên gia kiểm duyệt hoặc xây dựng quy trình kiểm soát chất lượng xuyên suốt dự án AI.
Amazon SageMaker Ground Truth
Amazon SageMaker Ground Truth là dịch vụ gán nhãn dữ liệu trong hệ sinh thái AWS, hỗ trợ chuẩn bị dữ liệu cho các dự án học máy. Nền tảng cung cấp nhiều loại tác vụ gán nhãn, cho phép kết hợp nhân lực với các phương pháp tự động hóa và hỗ trợ đánh giá chất lượng kết quả. Dữ liệu sau khi xử lý có thể được tích hợp vào quy trình phát triển mô hình trên AWS.
Công cụ này phù hợp với doanh nghiệp đang sử dụng hạ tầng AWS và muốn kết nối quá trình gán nhãn với các dịch vụ lưu trữ, xử lý dữ liệu và huấn luyện mô hình. Tuy nhiên, khi triển khai, cần cân nhắc chi phí sử dụng dịch vụ, cấu hình hệ thống và yêu cầu quản lý quyền truy cập dữ liệu.
>>> Xem thêm: Top 5 AI coding tools X5 tốc độ lập trình cho developer
[FAQs] Các câu hỏi thường gặp về Data Labeling
Làm thế nào để đánh giá chất lượng dữ liệu đã gán nhãn?
Đánh giá dựa trên độ chính xác, tính nhất quán và mức độ phù hợp của nhãn với mục tiêu huấn luyện. Có thể sử dụng dữ liệu chuẩn, kiểm tra mẫu ngẫu nhiên và rà soát lỗi để kiểm soát chất lượng.
Inter-Annotator Agreement (IAA) là gì?
IAA là chỉ số đo lường mức độ đồng thuận giữa những người cùng gán nhãn một dữ liệu. Chỉ số thấp có thể cho thấy tiêu chí gán nhãn chưa rõ ràng hoặc dữ liệu còn mơ hồ.
Data Labeling thủ công và tự động khác nhau như thế nào?
Gán nhãn thủ công dựa vào con người, phù hợp với dữ liệu phức tạp nhưng tốn thời gian. Gán nhãn tự động xử lý dữ liệu nhanh hơn nhưng cần kiểm tra để hạn chế sai sót.
Human-in-the-Loop trong Data Labeling là gì?
Human-in-the-Loop (HITL) là phương pháp kết hợp AI với sự kiểm duyệt của con người. AI đề xuất nhãn, sau đó người thực hiện xác minh và chỉnh sửa các trường hợp chưa chính xác.
Active Learning giúp tối ưu Data Labeling như thế nào?
Active Learning ưu tiên lựa chọn những mẫu dữ liệu có giá trị hoặc khiến mô hình chưa chắc chắn để gán nhãn. Phương pháp này giúp tiết kiệm nguồn lực và cải thiện hiệu quả huấn luyện.
Lời kết
Data Labeling giúp chuyển dữ liệu thô thành thông tin có nhãn để phục vụ huấn luyện và đánh giá AI. Lựa chọn đúng phương pháp, công cụ và tiêu chuẩn kiểm tra sẽ góp phần nâng cao chất lượng dữ liệu, tạo tiền đề cho các ứng dụng AI hoạt động hiệu quả hơn.


 Tầng 4, Tòa 97–99 Láng Hạ, Phường Đống Đa, Thành phố Hà Nội
 Điện thoại:
 Mail: sales@nhanhoa.com
 Phản ánh chất lượng dịch vụ: