



Nhu cầu chạy AI trực tiếp trên máy tính và hệ thống riêng ngày càng phổ biến, kéo theo sự quan tâm dành cho Local LLM. Công nghệ này cho phép triển khai các mô hình ngôn ngữ mà không cần phụ thuộc hoàn toàn vào dịch vụ AI bên ngoài. Vậy Local LLM là gì và đâu là những công cụ, model đáng chú ý? Cùng Nhân Hòa tìm hiểu ngay sau đây.
Local LLM là gì?
Local LLM (Large Language Model cục bộ) là mô hình ngôn ngữ lớn được tải xuống và chạy trực tiếp trên thiết bị hoặc máy chủ do người dùng kiểm soát, thay vì xử lý câu lệnh trên hệ thống máy chủ của nhà cung cấp AI. Quá trình suy luận có thể thực hiện bằng CPU hoặc GPU của máy tính, máy trạm hoặc server nội bộ.
Thay vì gửi dữ liệu lên các nền tảng AI đám mây để xử lý, Local LLM cho phép mô hình hoạt động trực tiếp trên thiết bị hoặc hệ thống máy chủ riêng. Nhờ đó, khi được triển khai hoàn toàn cục bộ và không kết nối với dịch vụ bên ngoài, dữ liệu đầu vào cũng như kết quả xử lý có thể được lưu trữ và kiểm soát ngay trong hệ thống.
Ví dụ: Các model có thể được triển khai theo mô hình Local LLM gồm Llama, Qwen, Mistral, Gemma và thường được chạy thông qua các công cụ như Ollama, LM Studio hoặc llama.cpp.
>>> Xem thêm: NLU là gì trong AI? Xu hướng tương lai của hệ thống hiểu ngôn ngữ
Ưu và nhược điểm của Local LLM
Local LLM mang lại nhiều lợi ích về quyền kiểm soát dữ liệu, khả năng tùy biến và tính chủ động khi triển khai AI. Tuy nhiên, mô hình này cũng đòi hỏi phần cứng, chi phí đầu tư và năng lực kỹ thuật phù hợp.
Các công cụ chạy Local LLM phổ biến
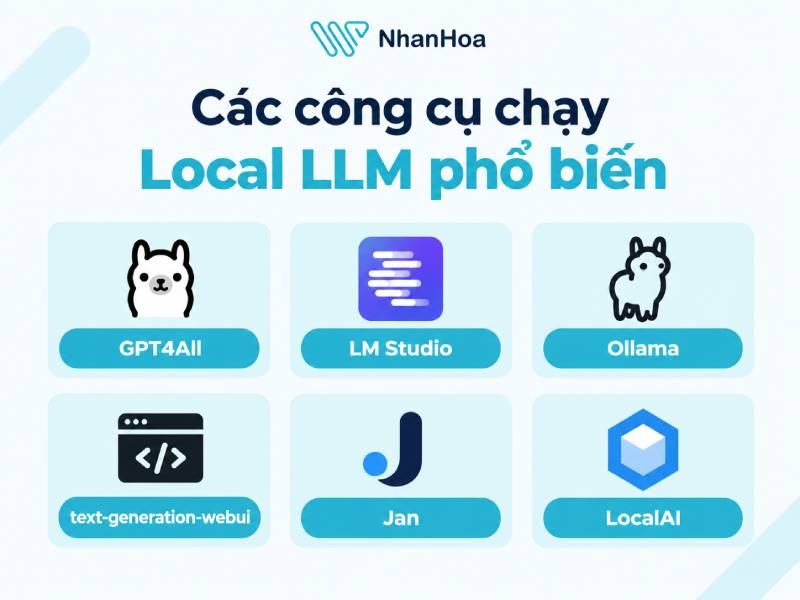
Để chạy Local LLM, người dùng có thể lựa chọn nhiều nền tảng với cách sử dụng và khả năng tùy chỉnh khác nhau. Một số công cụ được sử dụng phổ biến gồm GPT4All, LM Studio, Ollama, text-generation-webui, Jan và LocalAI.
GPT4All
GPT4All là ứng dụng desktop cho phép tải xuống và chạy các mô hình ngôn ngữ trực tiếp trên máy tính. Công cụ hướng đến khả năng sử dụng đơn giản, không yêu cầu người dùng phải thiết lập hệ thống AI phức tạp. GPT4All hỗ trợ Windows, macOS và Linux, đồng thời có thể kết hợp với LocalDocs để sử dụng các tệp lưu trữ trên máy làm nguồn thông tin cho model.
Một điểm đáng chú ý của GPT4All là khả năng vận hành các model trong khoảng 3 đến 13 tỷ tham số trên phần cứng phổ thông, phù hợp với nhu cầu sử dụng AI cá nhân trên laptop hoặc desktop. Công cụ cũng cung cấp API cục bộ để ứng dụng khác có thể gửi yêu cầu đến model đang chạy trên thiết bị.
Phù hợp với: Người mới bắt đầu sử dụng Local LLM, nhu cầu hỏi đáp, xử lý tài liệu cá nhân và thử nghiệm AI trên máy tính.
LM Studio
LM Studio cung cấp giao diện đồ họa để tìm kiếm, tải xuống và chạy các mô hình ngôn ngữ trực tiếp trên máy tính. Thay vì thao tác chủ yếu thông qua dòng lệnh, người dùng có thể quản lý model và thực hiện các phiên trò chuyện trong môi trường trực quan.
Ngoài chức năng trò chuyện, LM Studio còn phù hợp cho quá trình thử nghiệm model và xây dựng máy chủ AI cục bộ để các ứng dụng khác kết nối. Đây là lựa chọn đáng cân nhắc với người muốn trải nghiệm Local LLM nhưng chưa có nhiều kinh nghiệm về cấu hình bằng terminal.
Phù hợp với: Người dùng cá nhân, người mới làm quen với Local LLM và người cần giao diện trực quan để thử nghiệm nhiều model.
Ollama
Ollama là công cụ runtime dành cho việc chạy các mô hình ngôn ngữ trên máy tính hoặc máy chủ. Người dùng có thể tải và khởi chạy model thông qua dòng lệnh, sau đó tương tác với model hoặc kết nối model với các ứng dụng khác thông qua API cục bộ.
Ollama đặc biệt phù hợp với môi trường phát triển phần mềm vì có thể được tích hợp vào workflow của developer, ứng dụng AI hoặc các hệ thống cần sử dụng LLM nội bộ. Công cụ cũng thường được dùng làm backend cho các giao diện web và ứng dụng hỗ trợ Local LLM.
Phù hợp với: Developer, kỹ sư AI và các dự án cần tích hợp LLM vào ứng dụng hoặc hệ thống riêng.
text-generation-webui
text-generation-webui là giao diện web hỗ trợ chạy và quản lý các mô hình ngôn ngữ cục bộ. Công cụ cung cấp nhiều tùy chọn cấu hình, cho phép người dùng kiểm soát sâu hơn các thông số liên quan đến quá trình suy luận và cách model tạo nội dung.
So với các ứng dụng hướng đến người dùng phổ thông, text-generation-webui phù hợp hơn với người muốn chủ động thiết lập môi trường Local LLM, thử nghiệm nhiều cấu hình và khai thác các tùy chọn nâng cao.
Phù hợp với: Người dùng có kiến thức kỹ thuật, developer và những người cần tùy chỉnh sâu quá trình chạy model.
Jan
Jan là ứng dụng AI mã nguồn mở được thiết kế để chạy model trực tiếp trên máy tính. Công cụ cung cấp giao diện tập trung để người dùng quản lý và tương tác với các model, đồng thời có thể kết nối với một số dịch vụ AI thông qua API.
Jan hướng đến trải nghiệm sử dụng tương đối trực quan nhưng vẫn cung cấp khả năng kiểm soát môi trường AI cục bộ. Vì vậy, công cụ có thể đáp ứng cả nhu cầu sử dụng AI cá nhân và thử nghiệm các mô hình trong quá trình phát triển.
Phù hợp với: Người dùng muốn có một ứng dụng AI desktop thống nhất để sử dụng và quản lý model local.
LocalAI
LocalAI là nền tảng server dành cho việc triển khai các mô hình AI trên hạ tầng riêng. Công cụ cung cấp API tương thích với OpenAI API, từ đó cho phép các ứng dụng hiện có kết nối tới model cục bộ mà không phải phụ thuộc hoàn toàn vào dịch vụ AI bên ngoài.
LocalAI hỗ trợ nhiều backend và loại mô hình, đồng thời cho phép cài đặt model thông qua giao diện web, dòng lệnh hoặc các nguồn như Hugging Face. Người dùng cũng có thể tùy chỉnh cấu hình model, backend và các tham số phục vụ suy luận theo nhu cầu triển khai.
Phù hợp với: Doanh nghiệp, developer và đội ngũ kỹ thuật cần triển khai LLM trên server riêng, tích hợp AI vào ứng dụng hoặc xây dựng hệ thống AI nội bộ.
>>> Xem thêm: Transformer là gì? Kiến trúc chuyển đổi đứng sau AI chatbot
Một số model có thể triển khai Local LLM
Local LLM có thể sử dụng nhiều dòng model khác nhau, tùy thuộc vào cấu hình phần cứng, nhu cầu xử lý và khả năng của từng mô hình. Một số model phổ biến hiện nay gồm Llama, Qwen, Gemma, Mistral và DeepSeek.
- Llama: Dòng model của Meta, có nhiều kích thước và được hỗ trợ rộng rãi bởi các công cụ chạy LLM cục bộ. Phù hợp với nhiều tác vụ như trò chuyện, tạo nội dung, lập trình và hỏi đáp.
- Qwen: Dòng model của Alibaba, có nhiều phiên bản và kích thước khác nhau, hỗ trợ tốt các tác vụ ngôn ngữ, lập trình và xử lý đa ngôn ngữ.
- Gemma: Dòng model mã nguồn mở từ Google, được thiết kế theo hướng hiệu quả về tài nguyên. Các phiên bản nhỏ phù hợp với thiết bị cá nhân, trong khi model lớn hơn có thể triển khai trên GPU mạnh.
- Mistral: Các model của Mistral AI, nổi bật với nhiều phiên bản có kích thước tương đối nhỏ, phù hợp cho triển khai trên hạ tầng riêng và các ứng dụng cần kiểm soát tài nguyên.
- DeepSeek: Dòng model có nhiều phiên bản tập trung vào khả năng suy luận và lập trình. Một số bản Distill với kích thước nhỏ hơn có thể được triển khai trên phần cứng phổ thông hơn.
Cấu hình phần cứng để chạy Local LLM
Không có một cấu hình cố định cho mọi Local LLM. Yêu cầu phần cứng phụ thuộc chủ yếu vào kích thước model, định dạng model, mức độ lượng tử hóa và số lượng người dùng đồng thời.
Với model nhỏ đã được lượng tử hóa, hệ thống không có GPU rời vẫn có thể chạy bằng CPU và RAM. Tuy nhiên, tốc độ suy luận thường thấp hơn so với hệ thống có GPU phù hợp.
Khi lựa chọn cấu hình, nên xác định model và nhu cầu sử dụng trước rồi mới tính toán tài nguyên. Model càng lớn hoặc càng nhiều người dùng đồng thời thì yêu cầu về RAM, VRAM và khả năng xử lý càng cao.
Khi nào nên triển khai Local LLM?
Local LLM phù hợp khi hệ thống cần kiểm soát dữ liệu, hạn chế phụ thuộc vào API bên ngoài hoặc cần tích hợp AI sâu vào hạ tầng riêng. Một số trường hợp có thể cân nhắc gồm:
- Xây dựng chatbot hoặc trợ lý AI nội bộ.
- Xử lý tài liệu chứa thông tin cần kiểm soát.
- Xây dựng hệ thống RAG trên dữ liệu riêng.
- Phát triển công cụ hỗ trợ lập trình.
- Thử nghiệm model và ứng dụng AI trên máy cá nhân.
- Tích hợp AI vào phần mềm hoặc workflow nội bộ.
Ngược lại, nếu nhu cầu sử dụng không thường xuyên hoặc không có sẵn phần cứng phù hợp, sử dụng API AI hoặc dịch vụ AI trên cloud có thể đơn giản hơn về triển khai và vận hành.
Câu hỏi thường gặp về Local LLM
Local LLM có phù hợp với người không chuyên kỹ thuật không?
Có thể. Các công cụ như GPT4All và LM Studio cung cấp giao diện trực quan, giúp người dùng tải model và bắt đầu sử dụng mà không cần thiết lập hệ thống phức tạp. Tuy nhiên, các nhu cầu như tối ưu hiệu năng, triển khai server hoặc tích hợp API vẫn cần kiến thức kỹ thuật.
Local LLM có miễn phí không?
Nhiều model và công cụ Local LLM được cung cấp miễn phí hoặc theo giấy phép mã nguồn mở. Tuy nhiên, người dùng vẫn có thể phát sinh chi phí cho phần cứng, điện năng, lưu trữ và vận hành hệ thống.
Có thể chạy Local LLM không cần GPU không?
Có. Một số model nhỏ hoặc model đã lượng tử hóa có thể chạy trên CPU và RAM. Tuy nhiên, GPU thường mang lại tốc độ suy luận tốt hơn, đặc biệt khi sử dụng model lớn.
Local LLM có cần Internet không?
Không phải lúc nào cũng cần. Sau khi tải công cụ và model về máy, nhiều hệ thống có thể thực hiện suy luận hoàn toàn cục bộ mà không cần kết nối Internet.
Nên chọn model Local LLM như thế nào?
Nên dựa trên mục đích sử dụng, kích thước model, khả năng phần cứng, ngôn ngữ cần xử lý và yêu cầu về tốc độ. Model nhỏ phù hợp với thiết bị hạn chế tài nguyên, trong khi model lớn cần hệ thống có RAM và VRAM cao hơn.
Lời kết
Với khả năng chạy AI trên thiết bị hoặc hạ tầng riêng, Local LLM phù hợp với nhiều nhu cầu từ thử nghiệm mô hình đến phát triển ứng dụng. Mỗi công cụ và model có đặc điểm riêng, vì vậy cần cân nhắc mục đích sử dụng cùng cấu hình phần cứng trước khi triển khai.


 Tầng 4, Tòa 97–99 Láng Hạ, Phường Đống Đa, Thành phố Hà Nội
 Điện thoại:
 Mail: sales@nhanhoa.com
 Phản ánh chất lượng dịch vụ: