



Đằng sau khả năng trò chuyện, phân tích và tạo nội dung của nhiều AI chatbot hiện nay là một kiến trúc quan trọng mang tên Transformer. Vậy Transformer là gì và vì sao công nghệ này lại trở thành nền tảng của AI hiện đại?
Transformer (kiến trúc chuyển đổi) trong AI là gì?
Transformer là một kiến trúc mạng nơ-ron được giới thiệu trong nghiên cứu Attention Is All You Need năm 2017. Điểm đột phá của Transformer nằm ở việc sử dụng cơ chế self-attention để xác định mức độ liên quan giữa các token trong cùng một chuỗi, thay vì phải xử lý tuần tự như các mô hình RNN truyền thống. Nhờ đó, mô hình có thể nắm bắt ngữ cảnh giữa các từ ở những vị trí khác nhau và xử lý dữ liệu song song hiệu quả hơn.
Trong AI, Transformer đặc biệt quan trọng đối với xử lý ngôn ngữ tự nhiên (NLP), mô hình ngôn ngữ lớn (LLM) và AI tạo sinh. Kiến trúc này có thể được xây dựng theo dạng encoder, decoder hoặc kết hợp cả hai. Các mô hình decoder-only được sử dụng phổ biến cho nhiệm vụ tạo văn bản và hội thoại, trong khi encoder thường được dùng để phân tích, biểu diễn và hiểu nội dung đầu vào.
>>> Xem thêm: Mạng nơ-ron là gì?
Vai trò của Transformer đối với trí tuệ nhân tạo
Điểm cốt lõi của Transformer là Self-Attention, giúp mô hình xác định mối quan hệ giữa các thành phần trong dữ liệu.
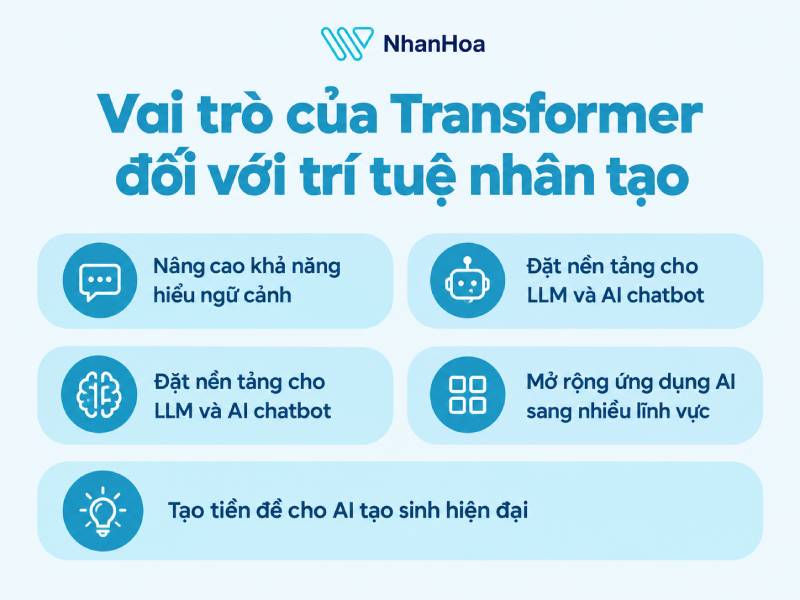
Nâng cao khả năng hiểu ngữ cảnh
Self-attention cho phép Transformer xác định mức độ liên quan giữa các từ hoặc token trong một chuỗi. Nhờ đó, AI có thể xem xét nhiều phần của câu cùng lúc để hiểu ý nghĩa và mối quan hệ giữa chúng.
Tăng khả năng xử lý dữ liệu song song
Không phụ thuộc vào việc xử lý tuần tự như các mạng RNN truyền thống, Transformer có thể xử lý nhiều token song song trong quá trình huấn luyện. Đây là yếu tố quan trọng giúp mô hình có thể mở rộng lên quy mô lớn và giảm thời gian huấn luyện.
Đặt nền tảng cho LLM và AI chatbot
Transformer trở thành kiến trúc chủ đạo của nhiều mô hình ngôn ngữ lớn. Các LLM dựa trên Transformer có thể thực hiện nhiều tác vụ như tạo văn bản, dịch máy, tóm tắt, hỏi đáp và xây dựng chatbot hội thoại.
Mở rộng ứng dụng AI sang nhiều lĩnh vực
Transformer không chỉ được sử dụng cho văn bản mà còn được ứng dụng trong hình ảnh, âm thanh, âm nhạc và nhiều dạng dữ liệu khác. Khả năng thích nghi với nhiều loại tác vụ là một trong những lý do kiến trúc này được sử dụng rộng rãi trong nghiên cứu và phát triển AI.
Tạo tiền đề cho AI tạo sinh hiện đại
Sự phát triển của Transformer đã tạo nền tảng kỹ thuật quan trọng cho các mô hình có khả năng tạo nội dung. Trong các kiến trúc decoder-only, mô hình có thể dự đoán token tiếp theo dựa trên ngữ cảnh trước đó để tạo ra văn bản và phản hồi hội thoại.
>>> Xem thêm: AI Automation là gì? Giải mã công nghệ tự động hóa bằng AI
Transformer hoạt động như thế nào?
Transformer xử lý dữ liệu dựa trên cơ chế Self-Attention, cho phép mô hình xem xét mối quan hệ giữa nhiều phần của chuỗi cùng lúc thay vì xử lý hoàn toàn tuần tự. Nhờ đó, mô hình có thể nắm bắt ngữ cảnh xa và xử lý dữ liệu hiệu quả hơn.
- Tiếp nhận dữ liệu: Văn bản được chia thành các token và chuyển thành các vector số thông qua embedding.
- Xác định vị trí: Thông tin vị trí được bổ sung để mô hình hiểu thứ tự của các token trong câu.
- Tập trung vào ngữ cảnh: Self-Attention xác định token nào có liên quan và cần được chú ý nhiều hơn khi xử lý từng phần dữ liệu.
- Tính toán mối quan hệ: Cơ chế Attention sử dụng Query, Key và Value để tính mức độ liên quan giữa các token.
- Xử lý qua nhiều lớp: Multi-Head Attention kết hợp nhiều hướng chú ý, sau đó dữ liệu tiếp tục qua Feed-Forward Network và các lớp hỗ trợ để tạo biểu diễn giàu ngữ cảnh hơn.
- Tạo kết quả: Với các mô hình tạo sinh, biểu diễn cuối cùng được dùng để dự đoán token tiếp theo, từ đó tạo thành câu trả lời hoặc nội dung hoàn chỉnh.
Các thành phần cấu tạo nên kiến trúc chuyển đổi
Kiến trúc Transformer gồm nhiều thành phần liên kết với nhau, đảm nhận các nhiệm vụ từ biểu diễn dữ liệu đầu vào, xác định ngữ cảnh đến tạo dự đoán đầu ra. Có thể khái quát thành 4 nhóm chính:
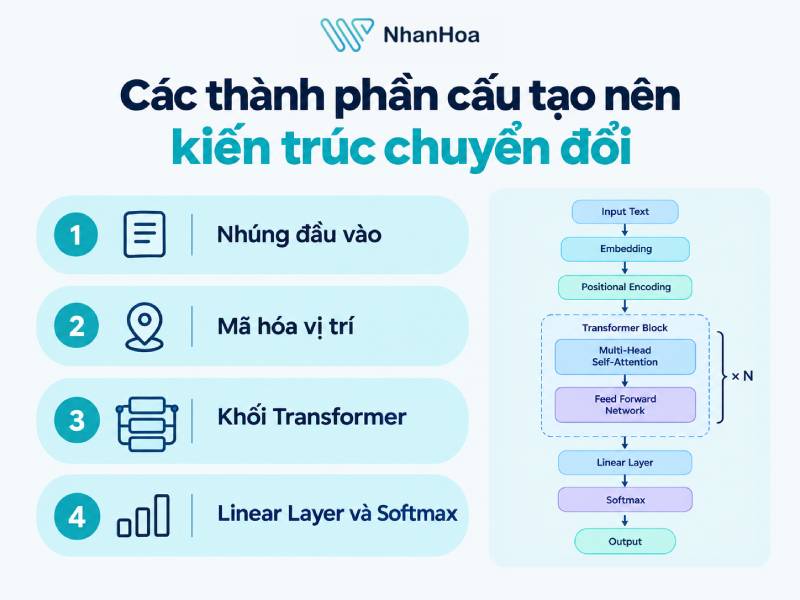
Nhúng đầu vào (Input Embedding)
Transformer trước tiên chuyển dữ liệu đầu vào thành các token, sau đó biểu diễn mỗi token dưới dạng một vector số. Các vector này chứa thông tin ngữ nghĩa và đặc trưng của dữ liệu, tạo cơ sở để mô hình phân tích mối quan hệ giữa các token trong toàn bộ chuỗi.
Mã hóa vị trí (Positional Encoding)
Do Transformer không xử lý dữ liệu theo thứ tự tuần tự như các mô hình truyền thống, mô hình cần bổ sung thông tin về vị trí của từng token. Positional Encoding giúp Transformer phân biệt thứ tự xuất hiện của các token và hiểu được cấu trúc của chuỗi đầu vào.
Khối Transformer (Transformer Block)
Đây là thành phần cốt lõi của kiến trúc Transformer, thường được xếp chồng thành nhiều lớp để xử lý dữ liệu ở các mức độ khác nhau. Mỗi khối thường gồm cơ chế Multi-Head Self-Attention và mạng Feed-Forward Network (FFN).
Multi-Head Self-Attention cho phép mô hình xác định mức độ liên quan giữa các token trong cùng một chuỗi. Trong khi đó, FFN tiếp tục xử lý biểu diễn thu được từ attention để tạo ra đặc trưng phù hợp cho các lớp tiếp theo. Residual Connection và Layer Normalization cũng được sử dụng để duy trì thông tin, ổn định quá trình huấn luyện và cải thiện khả năng học của mô hình.
Linear Layer và Softmax
Sau khi dữ liệu được xử lý qua các Transformer Block, Linear Layer chuyển biểu diễn cuối cùng thành các giá trị điểm số (logits) tương ứng với những token có khả năng xuất hiện tiếp theo. Softmax sau đó chuyển các điểm số này thành xác suất, từ đó mô hình lựa chọn token phù hợp để tạo ra đầu ra.
Trong Transformer nguyên bản, kiến trúc gồm Encoder và Decoder. Tuy nhiên, nhiều mô hình ngôn ngữ lớn hiện nay sử dụng kiến trúc Decoder-only, tập trung vào việc dự đoán token tiếp theo dựa trên ngữ cảnh đã có.
Khác biệt giữa Transformer và neural network khác
Mặc dù cùng được xây dựng để xử lý và học các đặc trưng từ dữ liệu, Transformer có cách tiếp cận khác biệt so với các kiến trúc neural network như RNN, LSTM hay CNN. Sự khác biệt chủ yếu nằm ở cơ chế xử lý dữ liệu, khả năng nắm bắt quan hệ trong chuỗi và mức độ song song hóa trong quá trình huấn luyện.
Các ứng dụng của Transformer
Transformer ban đầu được phát triển cho bài toán dịch máy nhưng hiện đã được mở rộng sang nhiều lĩnh vực nhờ khả năng xử lý dữ liệu dạng chuỗi và học mối quan hệ giữa các thành phần trong dữ liệu.
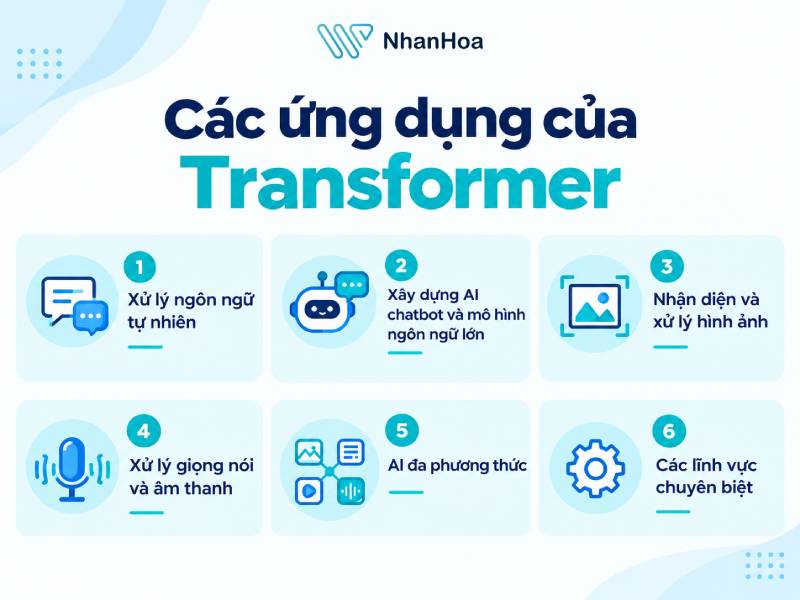
Xử lý ngôn ngữ tự nhiên
Transformer được sử dụng rộng rãi trong NLP cho các tác vụ như dịch máy, tóm tắt văn bản, phân loại nội dung, hỏi đáp, nhận diện thực thể và tạo văn bản. Đây cũng là nền tảng của nhiều mô hình ngôn ngữ lớn và chatbot AI hiện nay.
Xây dựng AI chatbot và mô hình ngôn ngữ lớn
Các mô hình Transformer dạng decoder có thể tạo văn bản bằng cách dự đoán token tiếp theo dựa trên ngữ cảnh. Cách tiếp cận này được sử dụng trong các mô hình ngôn ngữ phục vụ chatbot, trợ lý AI, tạo nội dung và nhiều ứng dụng sinh ngôn ngữ khác.
Nhận diện và xử lý hình ảnh
Transformer cũng được ứng dụng trong Computer Vision. Vision Transformer (ViT) chia hình ảnh thành các vùng nhỏ rồi biểu diễn chúng thành chuỗi để Transformer xử lý. Công nghệ này được sử dụng cho các bài toán như phân loại hình ảnh, phát hiện vật thể và phân đoạn ảnh.
Xử lý giọng nói và âm thanh
Trong lĩnh vực âm thanh, Transformer có thể được sử dụng cho nhận dạng giọng nói tự động, phân loại âm thanh và chuyển đổi giọng nói thành văn bản. Các mô hình như Whisper sử dụng kiến trúc encoder-decoder Transformer để xử lý dữ liệu âm thanh.
AI đa phương thức
Transformer còn được sử dụng để kết hợp nhiều loại dữ liệu như văn bản, hình ảnh, âm thanh và video. Các mô hình đa phương thức có thể thực hiện những tác vụ như hỏi đáp về hình ảnh, nhận diện nội dung trong tài liệu, tạo chú thích hình ảnh và tương tác giữa ngôn ngữ với hình ảnh.
Các lĩnh vực chuyên biệt
Ngoài NLP và Computer Vision, Transformer còn được nghiên cứu và ứng dụng trong nhiều lĩnh vực như robot, xe tự hành, sinh học, genomics và nghiên cứu protein.
[Giải đáp] Các câu hỏi thường gặp về Transformer
Self-Attention trong Transformer là gì?
Self-Attention cho phép mỗi token trong chuỗi xem xét mối liên hệ với các token khác để xác định thông tin nào cần được chú trọng khi tạo biểu diễn. Đây là cơ chế cốt lõi giúp Transformer nắm bắt mối quan hệ giữa các thành phần trong một chuỗi.
Tại sao Transformer cần Positional Encoding?
Transformer không xử lý tuần tự như RNN nên bản thân cơ chế self-attention không tự chứa thông tin về thứ tự của các token. Positional Encoding được thêm vào biểu diễn đầu vào để cung cấp thông tin về vị trí của từng token trong chuỗi.
Encoder và Decoder trong Transformer khác nhau như thế nào?
Encoder tập trung tạo biểu diễn từ dữ liệu đầu vào. Decoder sử dụng thông tin đó kết hợp với các token đã tạo để sinh chuỗi đầu ra. Trong Transformer nguyên bản, decoder còn sử dụng masked self-attention để không nhìn thấy các token tương lai.
GPT và BERT có phải là Transformer không?
Có. GPT sử dụng kiến trúc decoder-only, phù hợp với các nhiệm vụ sinh văn bản. BERT sử dụng encoder-only, phù hợp với những nhiệm vụ cần khai thác ngữ cảnh hai chiều. Ngoài ra còn có các mô hình sử dụng cả encoder và decoder cho các nhiệm vụ chuyển đổi một chuỗi thành chuỗi khác.
Lời kết
Transformer đã trở thành một trong những kiến trúc quan trọng trong AI nhờ khả năng xử lý ngữ cảnh và mối quan hệ giữa các token. Công nghệ này tiếp tục được ứng dụng rộng rãi trong chatbot, LLM, xử lý hình ảnh và AI đa phương thức.


 Tầng 4, Tòa 97–99 Láng Hạ, Phường Đống Đa, Thành phố Hà Nội
 Điện thoại:
 Mail: sales@nhanhoa.com
 Phản ánh chất lượng dịch vụ: